用 Opus 5.5 在 Cursor 里生成 Remotion 视频:给它 Key,一句话出成片
配套项目:
remotion-demo/。环境:Remotion 4.0.538、Node.js 22、Cursor + Claude Opus 5.5,旁白来自豆包语音合成 2.0 的真实调用。
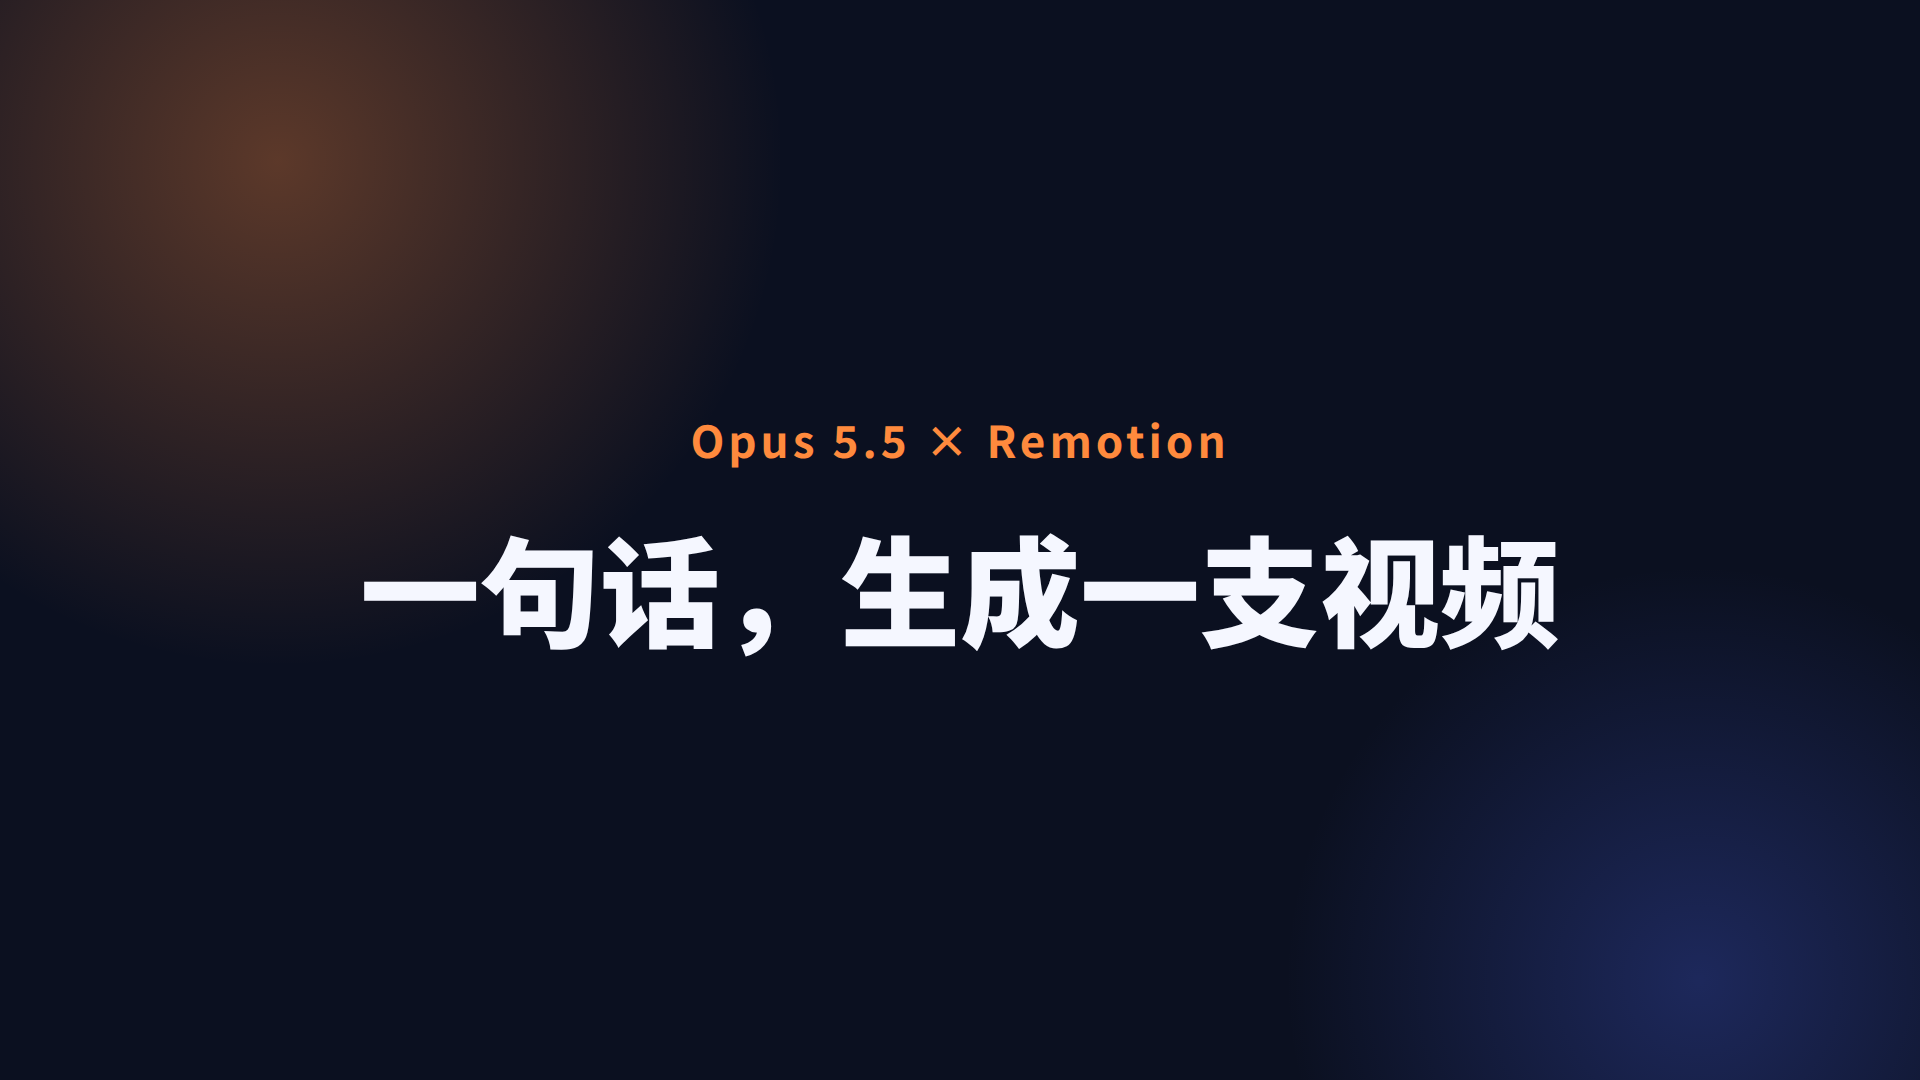
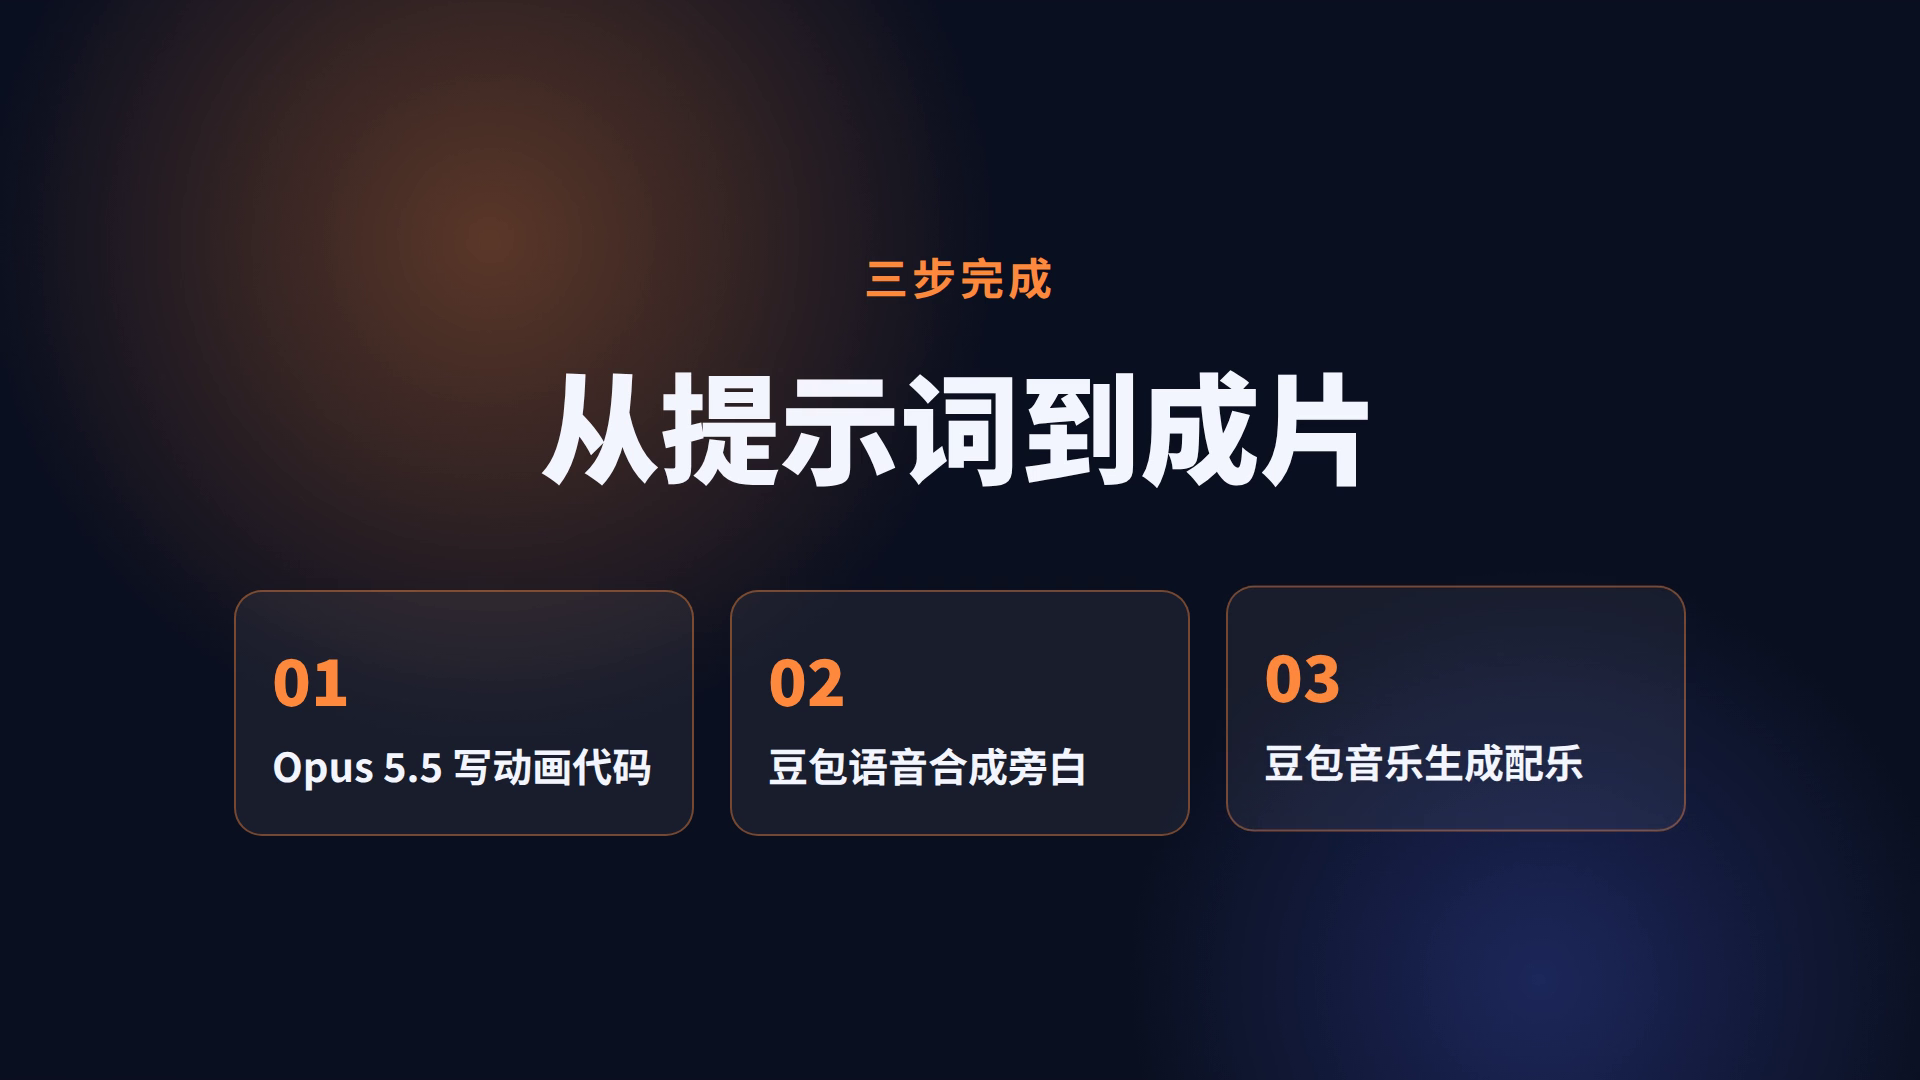
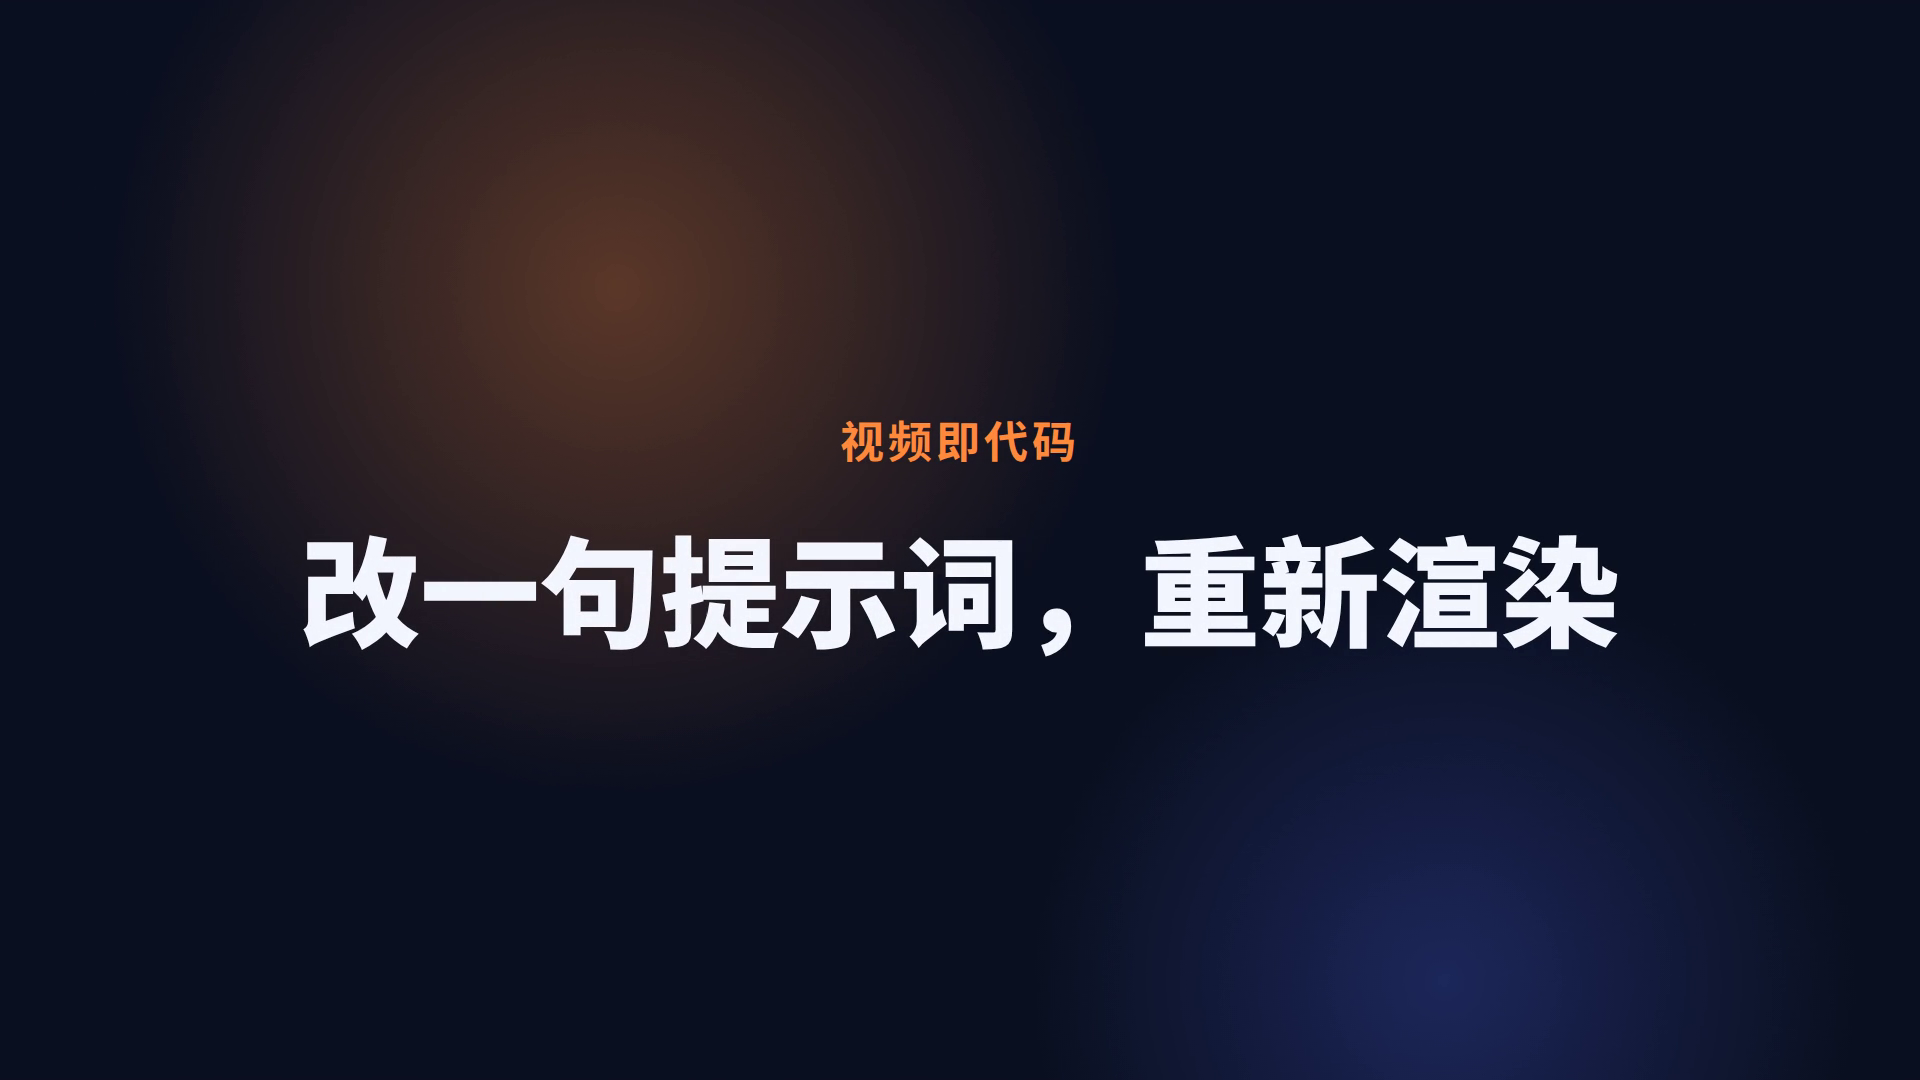
先看成品:一支 28 秒、1920×1080 的产品介绍短片,有动画、有中文旁白、有背景音乐。
| 开场 | 三步说明 | 结尾 |
|---|---|---|
 |
 |
 |
成片文件:docs/intro.mp4
这支视频的画面代码、配音脚本、配乐脚本,全部是 Opus 5.5 写的。我做的事情只有三件:建项目、给 Key、说需求。
1. Remotion 是什么,为什么适合交给 AI
Remotion 是一个用 React 写视频的框架。传统剪辑软件是在时间轴上拖素材,Remotion 则是写代码:视频的每一帧就是一次 React 渲染,组件根据「现在是第几帧」决定画面长什么样。
1.1 它是怎么把代码变成视频的
本项目的视频是 30fps、约 28 秒,一共 849 帧。渲染时,Remotion 把帧号 0、1、2……依次交给组件,Chromium 把每一帧的画面截下来,FFmpeg 再把这些画面和音频合成 MP4。
1.2 读懂代码只需要 6 个概念
你不需要会写 Remotion,但能读懂 AI 写的代码,改起来心里更有数:
| 概念 | 一句话解释 |
|---|---|
<Composition> |
注册一支视频:指定组件、宽高、帧率、总帧数 |
useCurrentFrame() |
返回当前是第几帧,所有动画都从它算出来 |
interpolate() |
把帧数映射成任意数值,例如第 0 到 30 帧,透明度从 0 变到 1 |
spring() |
弹簧动画,返回一个从 0 弹到 1 的数值,比线性动画更自然 |
<Sequence> / <Series> |
安排内容出现的时间段;Series 让多个场景首尾相接 |
<AbsoluteFill> |
铺满整个画面的容器,用来叠图层 |
最小的例子,标题在第 1 秒内淡入:
export const Title = () => {
  const frame = useCurrentFrame();
  const { fps } = useVideoConfig();
  const opacity = interpolate(frame, [0, 1 * fps], [0, 1], { extrapolateRight: "clamp" });
  return <h1 style={{ opacity }}>你好,Remotion</h1>;
};
这里有一条铁律:动画只能由帧数驱动。因为渲染是一帧一帧截图的,CSS transition、setTimeout 这类「按真实时间走」的动画,在预览里看着能动,渲染出来却是静止的。
1.3 为什么适合交给 AI
- Opus 5.5 写 React 得心应手,而 Remotion 视频本质上就是 React 组件。
- 改视频就是改代码,一句话就能改,结果完全可复现。
- 能接任何 API。你把 Key 给它,配音、配乐它自己去调接口生成,再精确地放到时间轴上。
2. 准备:两样东西
- Cursor:模型选 Opus 5.5,模式选 Agent。
- 火山引擎的 Key(没有也能做,只是没有声音):
| 用途 | 去哪开通 | 拿到什么 |
|---|---|---|
| 旁白(豆包语音合成) | 豆包语音控制台 开通「语音合成大模型」 | API Key |
| 配乐(豆包音乐生成) | AI 音乐生成控制台 开通服务 | 在 密钥管理 创建 AK/SK |
把 Key 写进项目根目录的 .env,告诉 AI 变量名就行:
DOUBAO_API_KEY=你的APIKey
VOLC_ACCESSKEY=你的AK
VOLC_SECRETKEY=你的SK
直接把 Key 贴进聊天框也能用,但 Key 会留在对话记录里。写进
.env更稳妥,记得确认它在.gitignore里。
先去试听,挑一个音色
旁白的声音决定了视频给人的第一印象。开通语音合成后,进入豆包语音控制台的 音色库,每个音色都可以直接点播放试听:
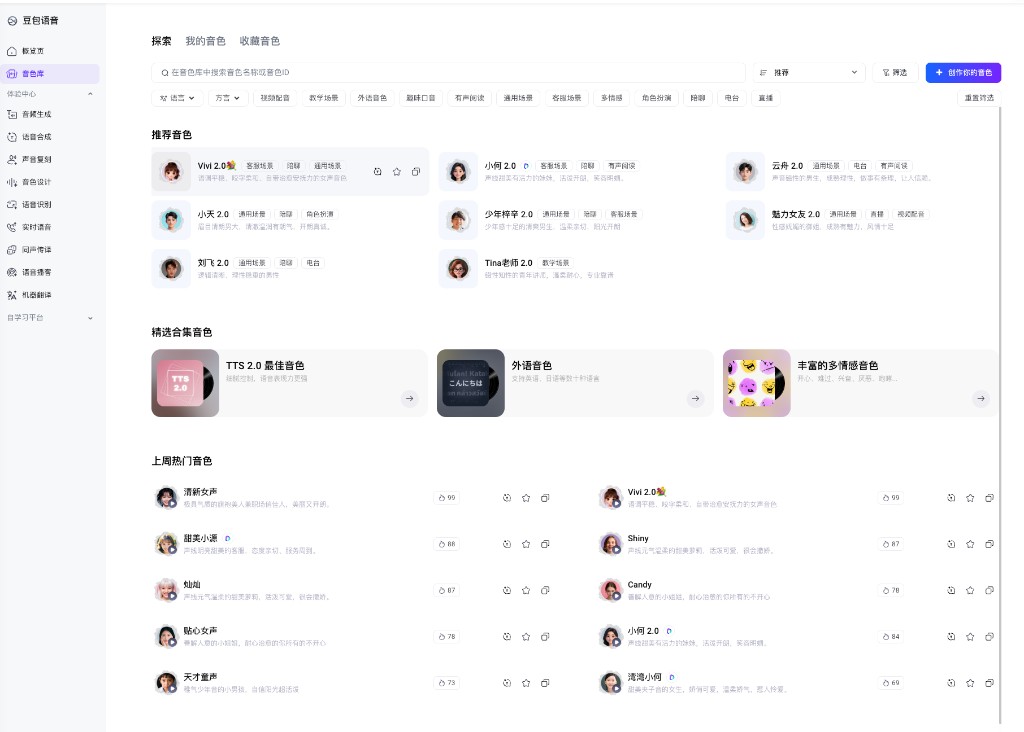
挑音色时注意三点:
- 优先选名字带「2.0」的音色,比如推荐区里的 Vivi 2.0、小何 2.0、云舟 2.0、刘飞 2.0。它们属于语音合成 2.0,和本文用的模型
seed-tts-2.0配套;选了 1.0 的音色会报resource ID is mismatched(见第 9 节)。 - 按视频类型看场景标签:产品介绍、教程类,选标着「通用场景」「教学场景」「有声阅读」、语气平稳清晰的音色;想要纪录片那种厚重感,选低沉的男声;轻松的短视频,可以试试活泼一点的声音。
- 用自己的旁白文案试听:同一个音色念不同的内容,感觉可能差很多。
选好后,把音色名称或音色 ID 告诉 Opus 5.5 就行,例如「旁白换成云舟 2.0」。本项目用的是 Vivi 2.0(音色 ID zh_female_vv_uranus_bigtts)。
3. 建项目
npx create-video@latest --yes --blank remotion-demo
cd remotion-demo
npx remotion skills add   # 给 AI 装上 Remotion 官方最新写法
npm run dev               # 打开 Remotion Studio
npx remotion skills add 这一步建议做:Remotion 更新很快,装上官方 skills 后,Opus 5.5 会按最新 API 写代码,而不是用训练数据里的旧写法。
这几条命令其实也可以直接让 Opus 5.5 替你跑。
Remotion Studio 是干什么的
npm run dev 会在浏览器里打开 Remotion Studio,它是 Remotion 自带的预览和调试工具。Opus 5.5 负责写代码,Studio 负责让你看到代码变成了什么画面。
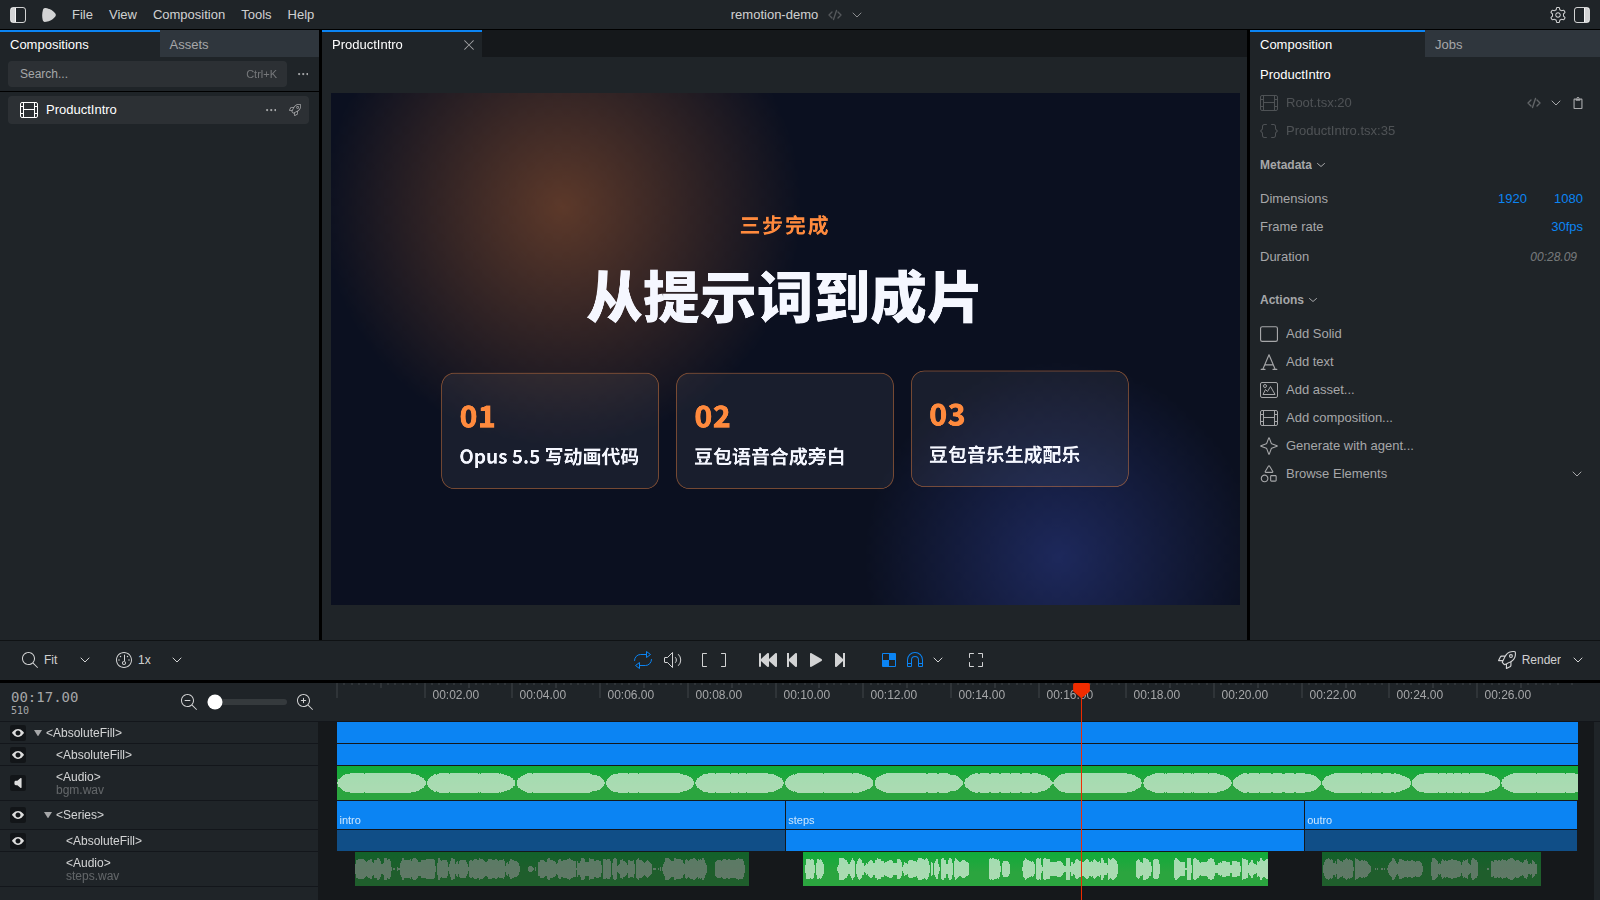
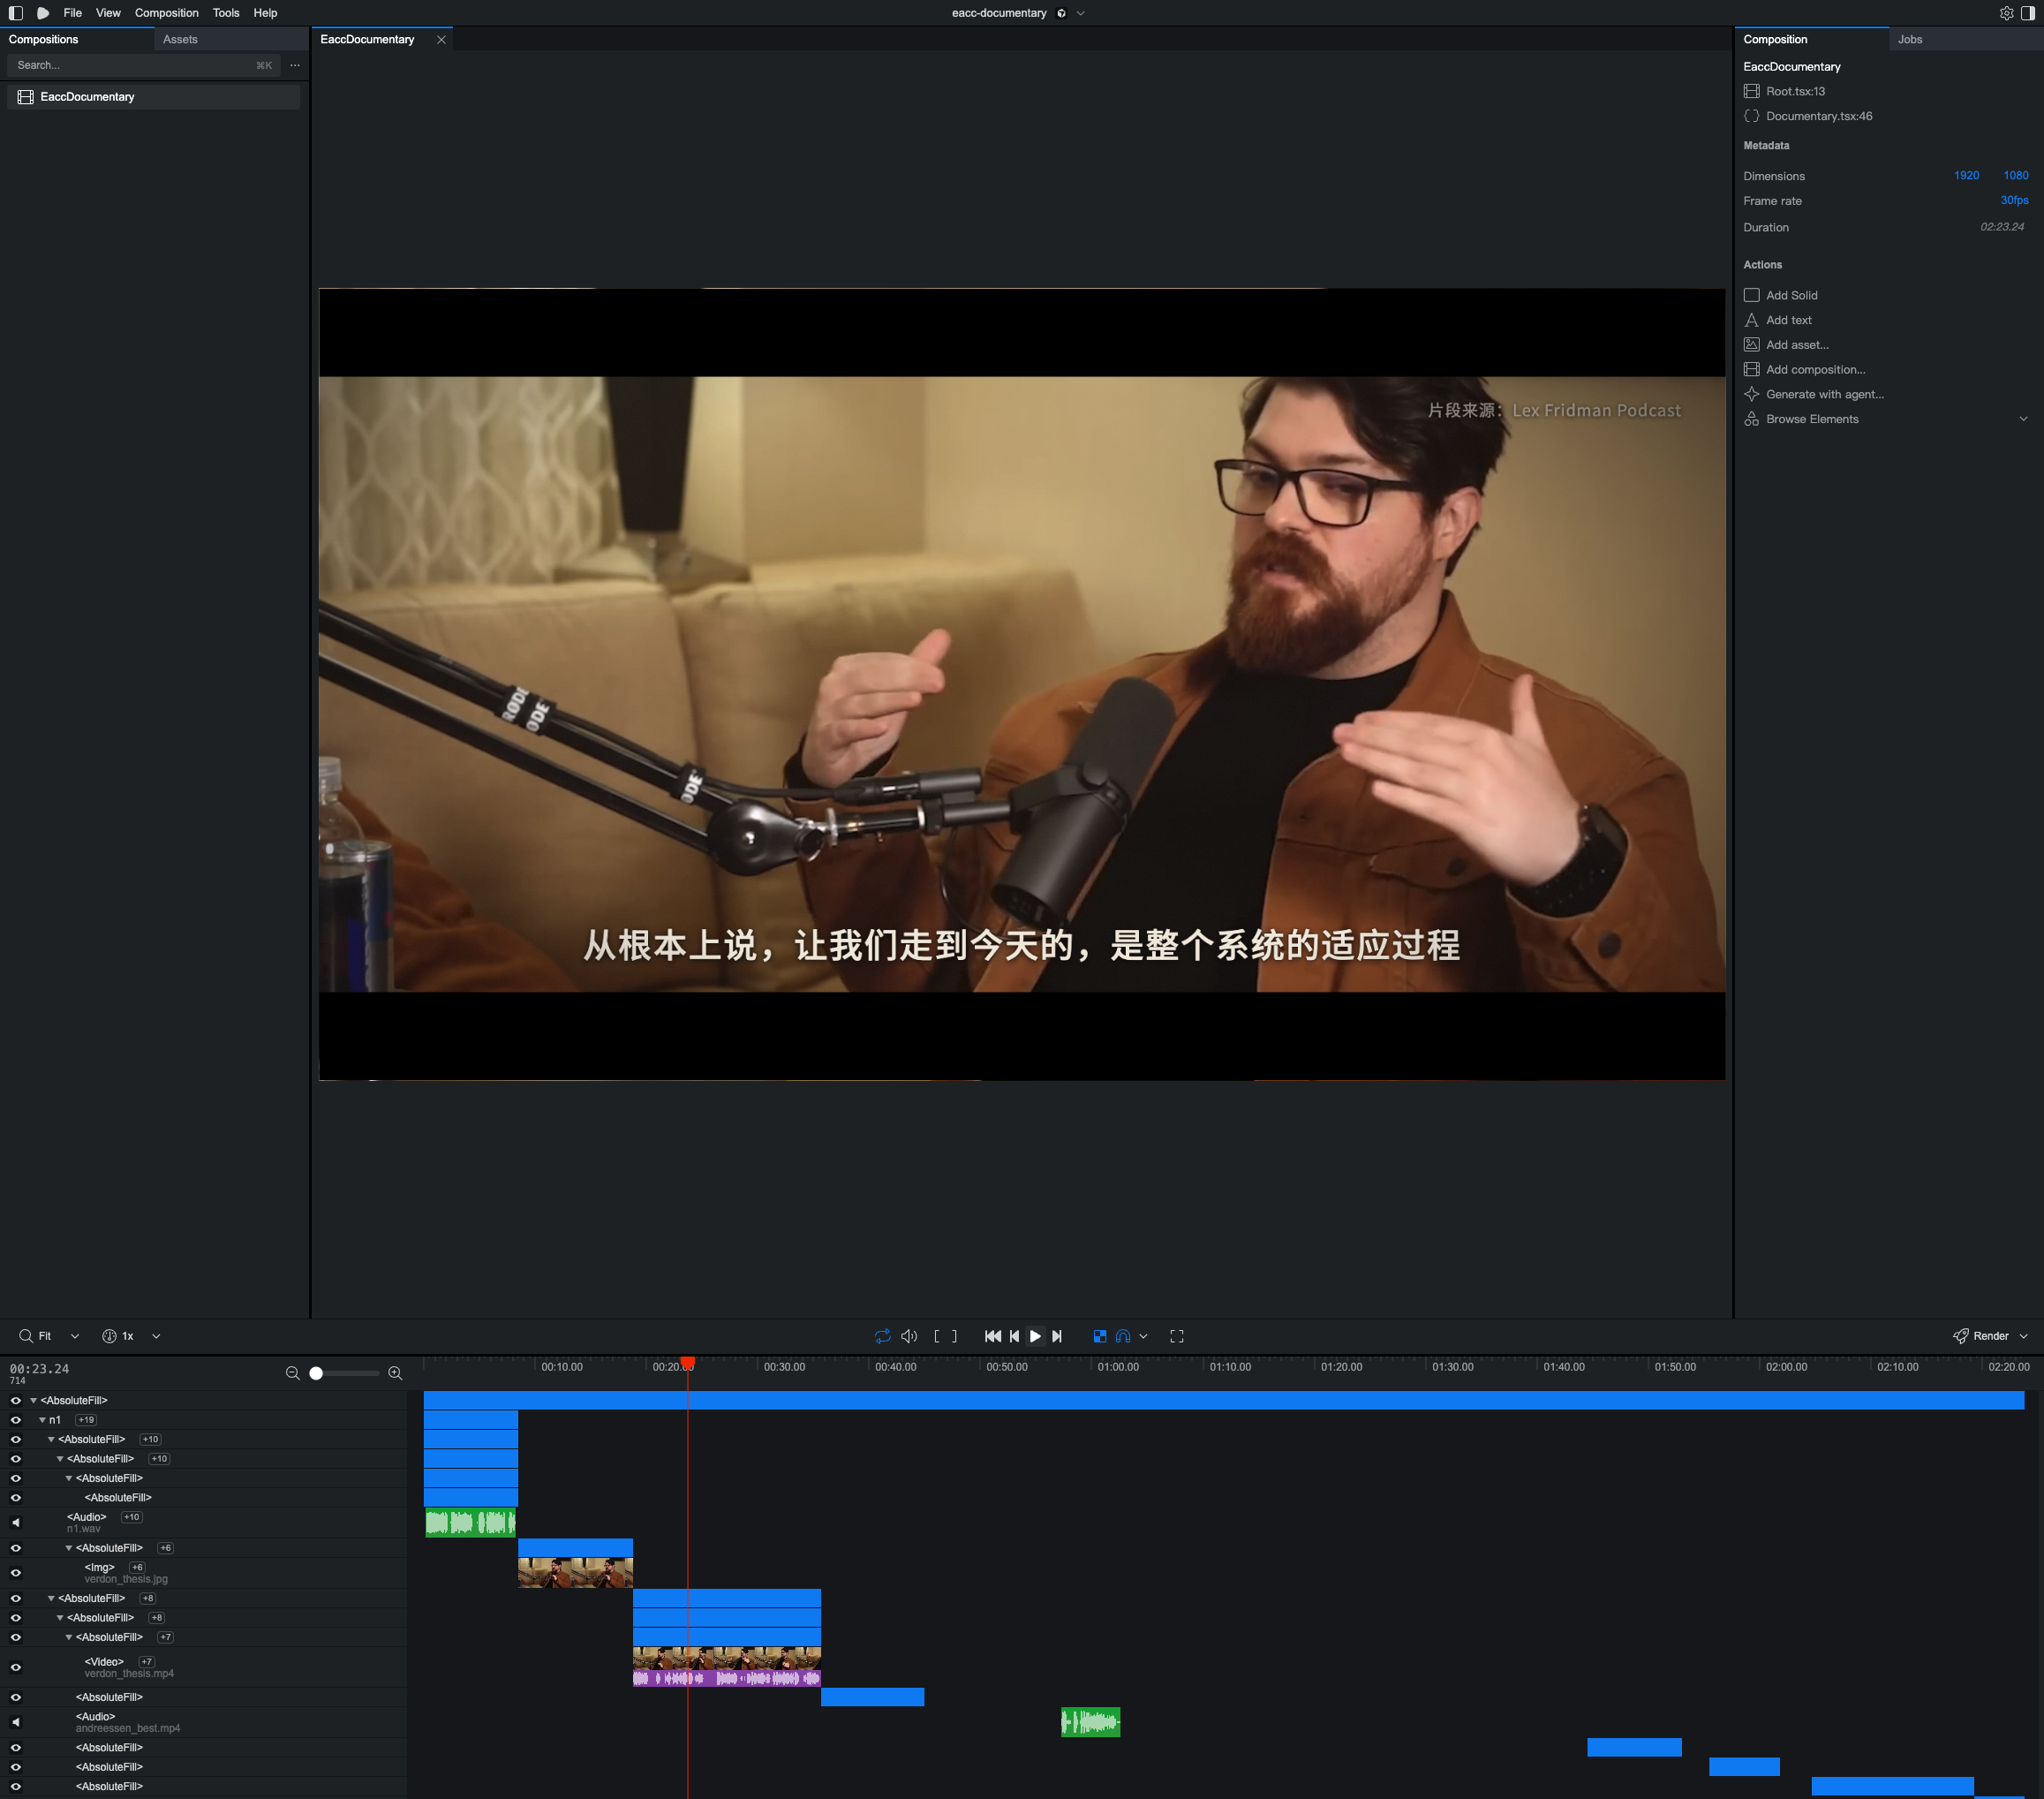
如果你用过剪映,打开 Studio 会觉得很眼熟:左边是素材和项目,中间是预览画面,下方是时间线,右边是属性面板。剪映里的概念,在 Studio 里几乎都能找到对应:
| 剪映里的概念 | Studio 里对应什么 | 在代码里是什么 |
|---|---|---|
| 项目 / 草稿 | 左侧 Compositions 列表里的一支视频 | <Composition> |
| 素材库 | 左侧 Assets 标签页 | public/ 目录里的文件 |
| 时间线 | 下方时间轴,顶部是时间刻度,红色播放头标出当前帧 | useCurrentFrame() 返回的帧号 |
| 片段 | 时间轴上的一个色块,比如截图里的 intro、steps、outro | <Sequence> / <Series.Sequence> |
| 视频轨 / 图层 | 时间轴左侧的每一行,可以展开、折叠 | 组件树里的一个元素,例如 <AbsoluteFill> |
| 音频轨 | 带波形的那几行,比如 bgm.wav 和每段旁白 |
<Audio> |
| 隐藏图层、静音 | 每行左边的眼睛图标和喇叭图标 | 只影响预览,不改代码 |
| 属性面板 | 右侧面板,显示宽高、帧率、时长,以及添加文字、素材等操作 | <Composition> 的参数和 props |
| 导出 | 右下角 Render 按钮,任务进度在右上角 Jobs 标签页 | npx remotion render |
图层的上下关系也和剪映一样:上面的图层盖住下面的。区别在于,Remotion 里是代码中越靠后的元素越在上层。看本项目的结构:
<AbsoluteFill>
  <Background />        {/* 最底层:深色背景和光斑 */}
  <BackgroundMusic />   {/* 音频不占画面 */}
  <Series>              {/* 上层:三个场景依次播放 */}
    <Series.Sequence>…</Series.Sequence>
  </Series>
</AbsoluteFill>
所以时间轴上的每一行,就是代码里的一个组件;时间轴上色块的起止位置,就是 <Sequence> 的开始帧和时长。
最大的不同:剪映主要靠手拖,Studio 的时间线主要用来「看」和「定位」。右侧面板虽然也能添加文字、素材,但大部分修改还是落在代码上,也就是对 Opus 5.5 说一句话。这正是它适合交给 AI 的原因:剪映的操作没法复现,代码可以。
其他要点:
- 实时刷新:AI 每改一次代码,这里自动更新。改完立刻看效果,不满意接着说。
- 对齐检查:在时间轴上一眼就能看出卡片弹出和旁白是不是对得上。
- 报错:画面上出现红色报错时,原文贴给 Opus 5.5 就行。
- 预览不等于成片:Studio 是浏览器实时播放,最终渲染是逐帧截图。预览卡顿不代表成片会卡。
4. 一句话生成整支视频
在 Cursor 里发送类似这样的提示词,按你的产品改就行:
用 Remotion 做一支 1920x1080、30fps 的产品介绍短片,主题是
「用 Opus 5.5 + Remotion 一句话生成视频」,分开场、三步说明、结尾三个场景,深色科技风。

- 中文旁白用火山引擎豆包语音合成 2.0,Key 在 .env 的 DOUBAO_API_KEY。
- 背景音乐用豆包音乐生成纯音乐,AK/SK 在 .env 的 VOLC_ACCESSKEY / VOLC_SECRETKEY。
- 场景时长跟着旁白长度走,背景音乐压低音量,不要盖过旁白。
- 配音和配乐做成 npm 脚本,以后改了文案能一键重新生成。
Opus 5.5 实际做了什么:
| 它生成的东西 | 作用 |
|---|---|
src/storyboard.json |
分镜:每个场景的标题、旁白,配乐描述。文案和代码分开,改文案不用碰组件 |
src/ProductIntro.tsx、src/components/ |
画面:spring 弹入的标题、依次弹出的三张卡片、漂移的光斑背景 |
scripts/tts.mjs |
调豆包语音合成,为每个场景生成旁白 WAV 并记录时长 |
scripts/music.mjs |
调豆包音乐生成,提交任务、轮询、下载配乐 |
src/timeline.ts、src/Root.tsx |
按旁白时长算出每个场景的帧数和视频总长 |
接口鉴权(包括火山引擎的 V4 签名)、跑脚本、检查结果、运行 lint,这些都由它自己完成。配音脚本的实际输出:
✓ intro  9.02s  → public/voiceover/intro.wav
✓ steps  10.619s  → public/voiceover/steps.wav
✓ outro  5.01s  → public/voiceover/outro.wav
本项目编写时没有配音乐的 AK/SK,所以
public/music/bgm.wav是脚本本地合成的和弦占位。配好 Key 后运行npm run music就会换成真实配乐。
5. 拆开看:Opus 5.5 是怎么做到的
一句话出成片,背后是它把需求拆成了一个个具体问题,再逐个用代码解决。下面挑五个例子,每个都是「要达到什么效果 → 它怎么做的」。
5.1 文案和画面分开:改文案不用碰代码
目标:以后改标题、改旁白,不想去翻组件代码。
做法:它把所有文案放进 src/storyboard.json,组件只负责「怎么呈现」。配音脚本、配乐脚本、画面组件都读这同一份数据(节选):
{
  "music": { "prompt": "科技产品发布会的背景纯音乐,轻快、明亮……", "durationInSeconds": 45 },
  "scenes": [
    { "id": "intro", "kicker": "Opus 5.5 × Remotion", "heading": "一句话,生成一支视频", "voice": "只用一句话……" },
    { "id": "steps", "heading": "从提示词到成片", "points": ["Opus 5.5 写动画代码", "豆包语音合成旁白", "豆包音乐生成配乐"], "voice": "第一步……" },
    { "id": "outro", "heading": "改一句提示词,重新渲染", "voice": "视频就是代码……" }
  ]
}
5.2 三张卡片依次弹出:让动画「晚一点开始」
目标:「三步说明」里的三张卡片,跟着旁白里的「第一步、第二步、第三步」依次出现。
做法(SceneView.tsx):
{points.map((point, i) => {
  const progress = spring({
    frame: frame - Math.round((0.8 + i * 2.8) * fps), // 第 i 张卡片延迟 0.8 + i × 2.8 秒
    fps,
    config: { damping: 14, stiffness: 120 },
  });
  return <div style={{ opacity: progress, translate: `0 ${interpolate(progress, [0, 1], [60, 0])}px` }}>…</div>;
})}
关键是 frame - 延迟帧数:把当前帧往回减,spring 就晚一点开始。progress 从 0 弹到 1,同时驱动透明度和位移,卡片就「弹」了出来。这正是 1.2 节那几个概念的组合。
5.3 拿到旁白的精确时长:选 PCM 而不是 MP3
目标:每个场景该多长,取决于旁白念多久,所以必须精确知道每段旁白的时长。
做法(scripts/tts.mjs):调用豆包语音合成时,它没有要 MP3,而是要了未压缩的 PCM(24000Hz、16 位),自己加上 WAV 头保存。原因很简单:PCM 的时长可以直接算出来,
不需要额外装音频解析库。算出的时长写进 src/generated/voiceover.json,交给下一步使用。
5.4 画面跟着旁白走:时长由数据算出来
目标:改了旁白文案、重新配音后,场景切换点自动对齐,不用手动调。
做法:src/timeline.ts 用旁白时长算出每个场景的帧数,前后各留一点呼吸时间:
const seconds = PADDING_BEFORE_SECONDS + voice.durationInSeconds + PADDING_AFTER_SECONDS; // 0.4 + 旁白 + 0.8
return { scene, voiceFile: voice.file, durationInFrames: Math.ceil(seconds * fps) };
src/Root.tsx 用 Remotion 的 calculateMetadata 把各场景加起来作为视频总长;src/ProductIntro.tsx 用 <Series> 把场景首尾相接,每段旁白放进自己的场景:
<Series>
  {timeline.map(({ scene, voiceFile, durationInFrames }) => (
    <Series.Sequence key={scene.id} durationInFrames={durationInFrames}>
      <SceneView scene={scene} />
      <Audio src={staticFile(voiceFile)} from={Math.round(VOICE_DELAY_SECONDS * fps)} />
    </Series.Sequence>
  ))}
</Series>
于是整条链路是:改文案 → npm run voice → 时长变了 → 场景帧数和总长自动跟着变。
5.5 背景音乐:异步生成,再用音量曲线混音
目标:生成一段配乐,并且不盖过旁白。
做法分两半:
- 生成(
scripts/music.mjs):豆包音乐是异步接口,生成要花一些时间。它先调GenBGM提交任务拿到TaskID,再每 5 秒调QuerySong查询,状态变成成功后下载音频。火山引擎 OpenAPI 要求 V4 签名(HMAC-SHA256 逐级派生密钥),它没有引入 SDK,而是直接用 Node 自带的crypto实现了。 - 混音(
ProductIntro.tsx):volume也可以按帧变化,它用interpolate做了一条「淡入、保持、淡出」的音量曲线:
<Audio
  src={staticFile(music.file)}
  loop
  volume={interpolate(
    frame,
    [0, 1 * fps, durationInFrames - 1.5 * fps, durationInFrames],
    [0, 0.18, 0.18, 0], // 1 秒淡入到 0.18,结尾 1.5 秒淡出
    { extrapolateLeft: "clamp", extrapolateRight: "clamp" },
  )}
/>
和画面动画一样,声音也是由帧数驱动的。
6. 一句话改视频
满意之前,就是不停地在 Cursor 里说、在 Studio 里看:
| 想改什么 | 直接说 |
|---|---|
| 配色 | 「主色换成青绿色 #2dd4bf,光斑也跟着换」 |
| 节奏 | 「三张卡片出得再快一点,和旁白里的『第二步』『第三步』对齐」 |
| 转场 | 「场景之间加 0.5 秒淡入淡出转场」 |
| 字幕 | 「把旁白作为字幕显示在画面底部」 |
| 竖屏 | 「再做一个 1080x1920 的竖屏版本」 |
| 旁白 | 「开场改得更有悬念,换男声,重新配音」 |
| 配乐 | 「背景音乐换成 lo-fi 风格,然后重新生成」 |
因为场景时长跟着旁白走,改完文案重新配音,画面会自动对齐,不用手动调时间。
连想要什么风格都说不上来?或者希望每次做出来的风格都一致?见第 12 节的进阶用法。
7. 渲染导出
npm run render # 等价于 npx remotion render ProductIntro out/intro.mp4
调试时加 --scale=0.5 出个低清版会快很多。
共享内存捕获:新版 Remotion 自动提速
回到 1.1 节的流程图:Chromium 截下每一帧,交给 FFmpeg 编码。传统做法中间多了一来一回:
「压缩成图片、再解码回位图」纯属浪费,JPEG 压缩还会损失一点画质。从 Remotion v4.0.534 开始,Remotion 用一个特制的 Chromium 把每一帧的未压缩位图通过共享内存直接交给 FFmpeg,省掉了这两步。不需要任何配置,满足条件就自动开启:
- macOS:Apple Silicon + macOS 15 及以上;
- Linux:x64 或 ARM64,glibc 2.35 及以上(Ubuntu 22.04 及更新);
- 只对视频渲染生效,Studio 预览不使用。其他环境会自动退回传统方式,不影响渲染。
确认是否生效:加 --log=verbose,日志里出现 Remotion shared-memory capture uses the POSIX shared-memory backend. 即可。
在 4 核 Linux 云主机上渲染本项目(849 帧,1080p),开启比关闭快约 5% 到 10%。画面越复杂、分辨率越高,提升越明显。用 npx remotion benchmark 测自己的项目最准。
8. 想让它更稳:可选的两件事
Opus 5.5 不靠这些也能做出来,但项目大了、要反复迭代时,下面两样能让它少走弯路:
- Cursor Rule:把项目约定写进
.cursor/rules/remotion.mdc,比如「动画只能由useCurrentFrame()驱动,禁止 CSS transition」。可以直接让 Opus 5.5 帮你写。 - Agent Skill:让它把配音、配乐的用法整理成
.agents/skills/doubao-tts和doubao-music。以后在 Cursor 或 Codex 里说「重新配音」,它就知道该跑哪个脚本、出错怎么查。
9. 常见问题
动画在 Studio 里能动,渲染出来却是静止的?
代码里用了 CSS 动画或 setTimeout。告诉 Opus 5.5「所有动画改成 useCurrentFrame 驱动」。
中文显示成方块?
让它用 @remotion/google-fonts 加载 Noto Sans SC。
配音报 resource ID is mismatched?
豆包的音色和模型版本要配套:*_uranus_bigtts 音色配 seed-tts-2.0。把报错贴给 Opus 5.5,它会自己改。
没有火山引擎账号能做吗? 可以,让它在没有 Key 时生成占位音频,视频照样能预览和渲染。
Remotion 收费吗? 个人、非营利组织和 3 人及以下的公司免费;更大的公司需要购买 Remotion 公司授权。
10. 实战案例一:一条消息做出比赛解说短片
这是一个真实需求:技术运营大赛结束后,要做一支赛后题目解析短片,用主视觉海报上的企鹅当虚拟主持人,替代真人主持。这一节记录的是第一步:从一条消息到「开场 + 第一题」的第一版成片。这一步是 one-shot 完成的,内容上我没有提过一次修改意见,中间唯一的来回是配音 Key 的事(下面会讲)。
这个项目是在 Cursor 的 Project(云端 Agent)里用 Opus 5.5 做的:主 Agent 负责跟我沟通、拆任务,把具体制作交给一个叫「Build penguin-hosted explainer video」的 worker。从建项目到交付第一版,大约 50 分钟。
10.1 成品(第一版)
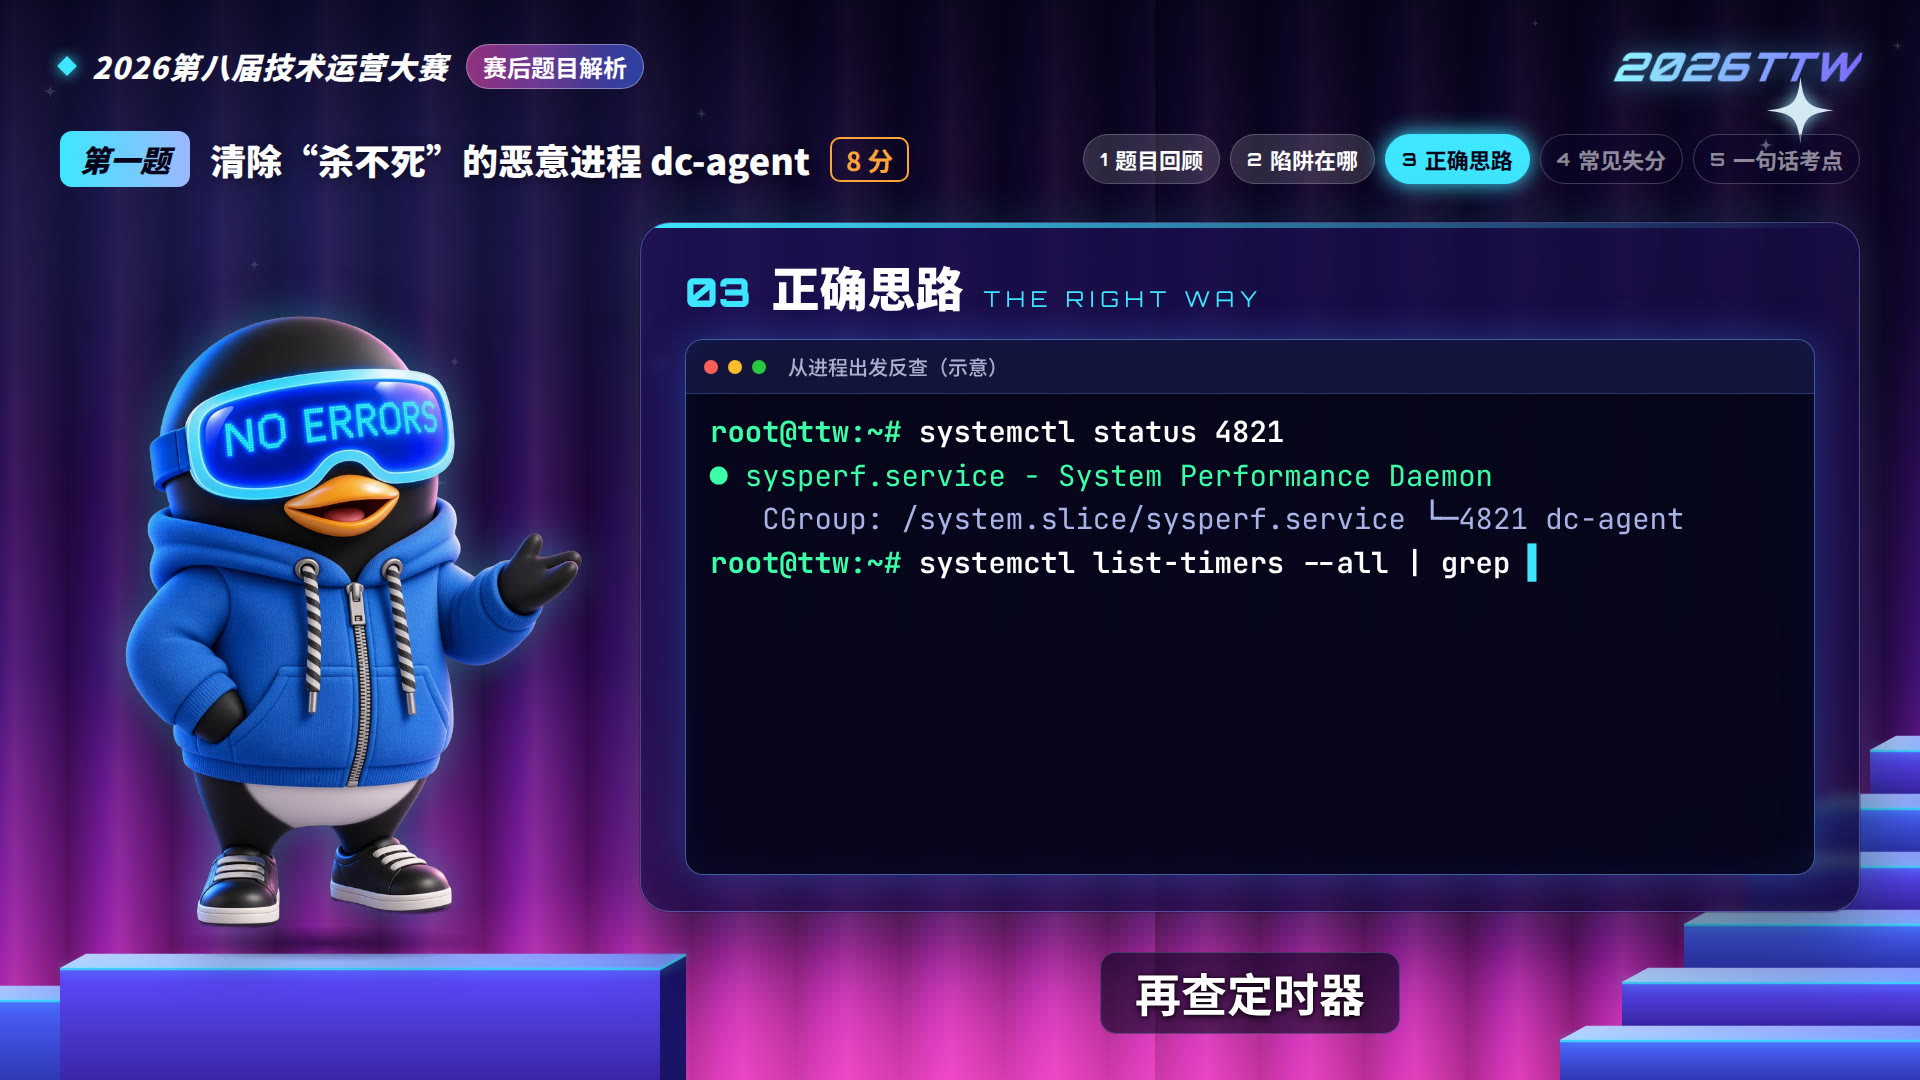
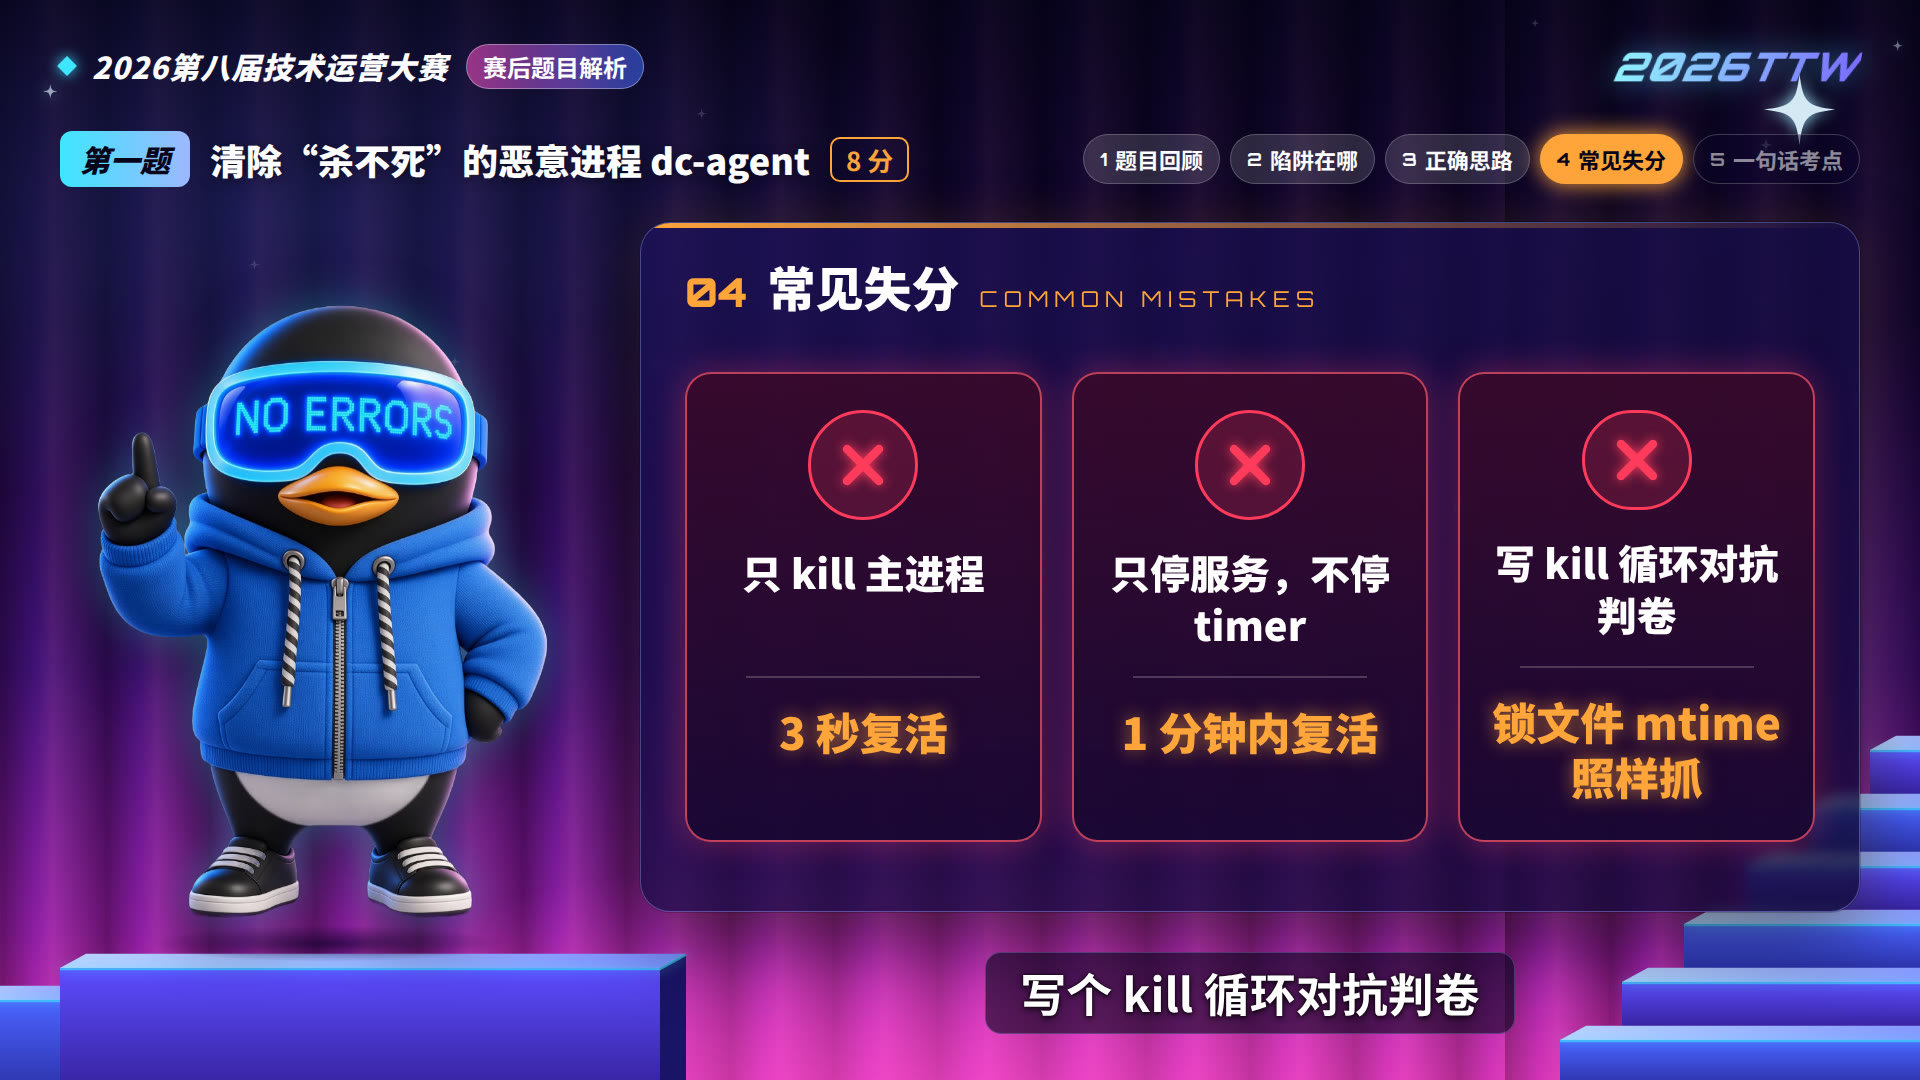
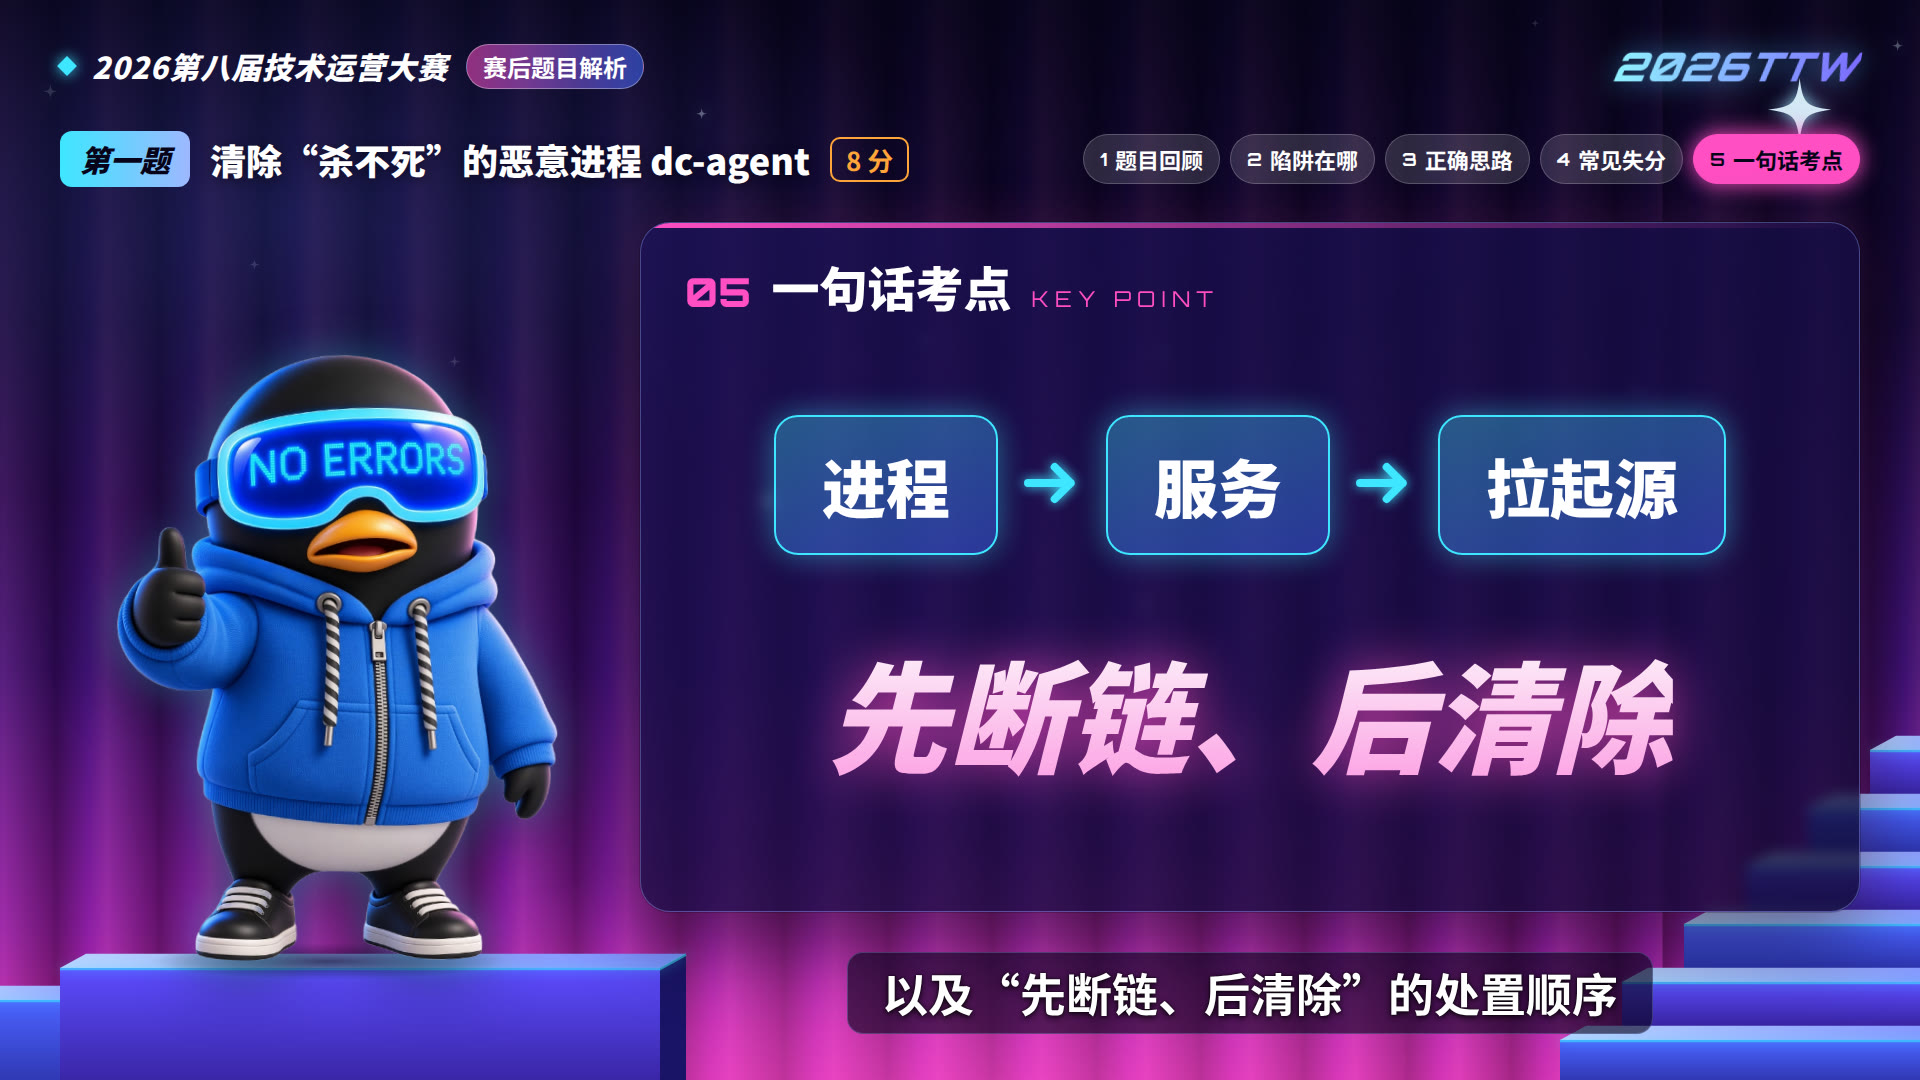
2 分 43 秒、1920×1080:片头 → 开场 → 第一题,第一题按「题目回顾 → 陷阱在哪 → 正确思路 → 常见失分 → 一句话考点」讲完。企鹅的嘴跟着配音音量开合,会随讲解换手势;右边的面板在旁白念到关键词时弹出对应的卡片、终端和示意图。
| 片头 | 开场 |
|---|---|
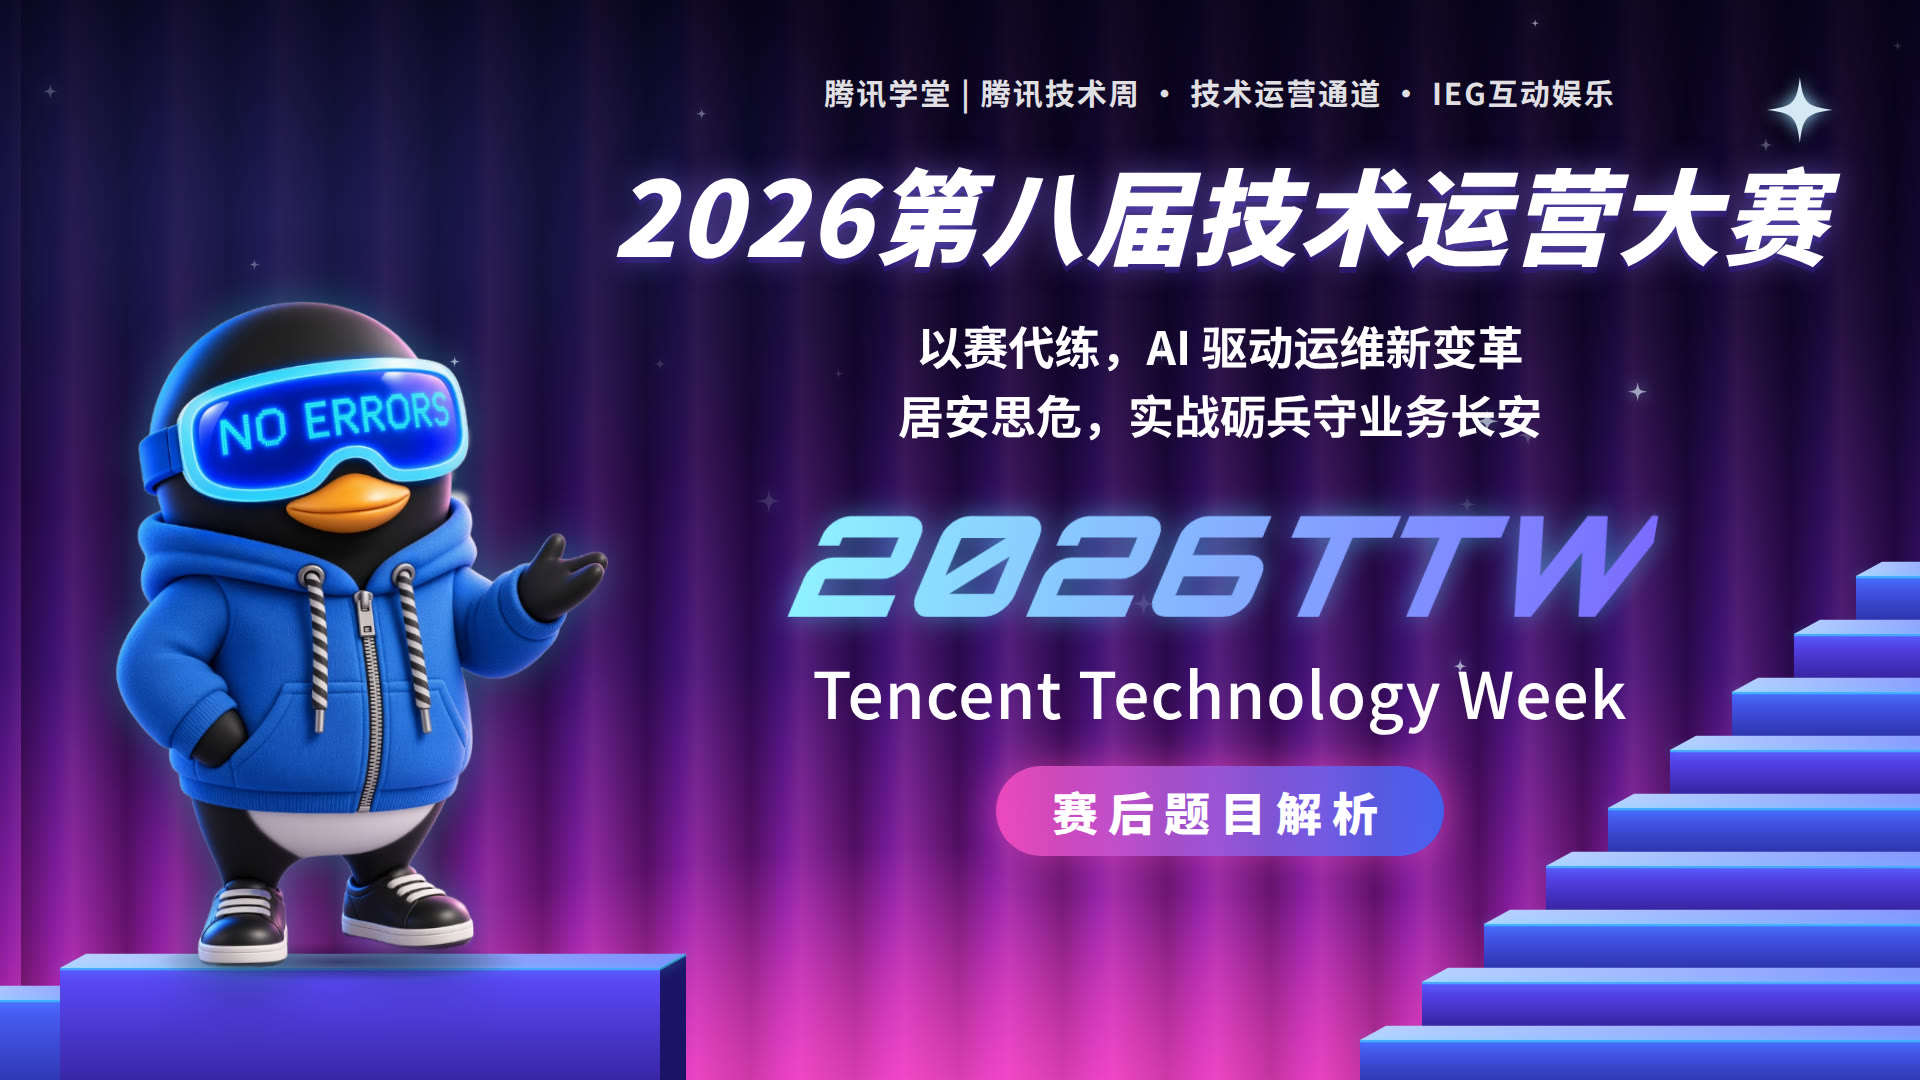 |
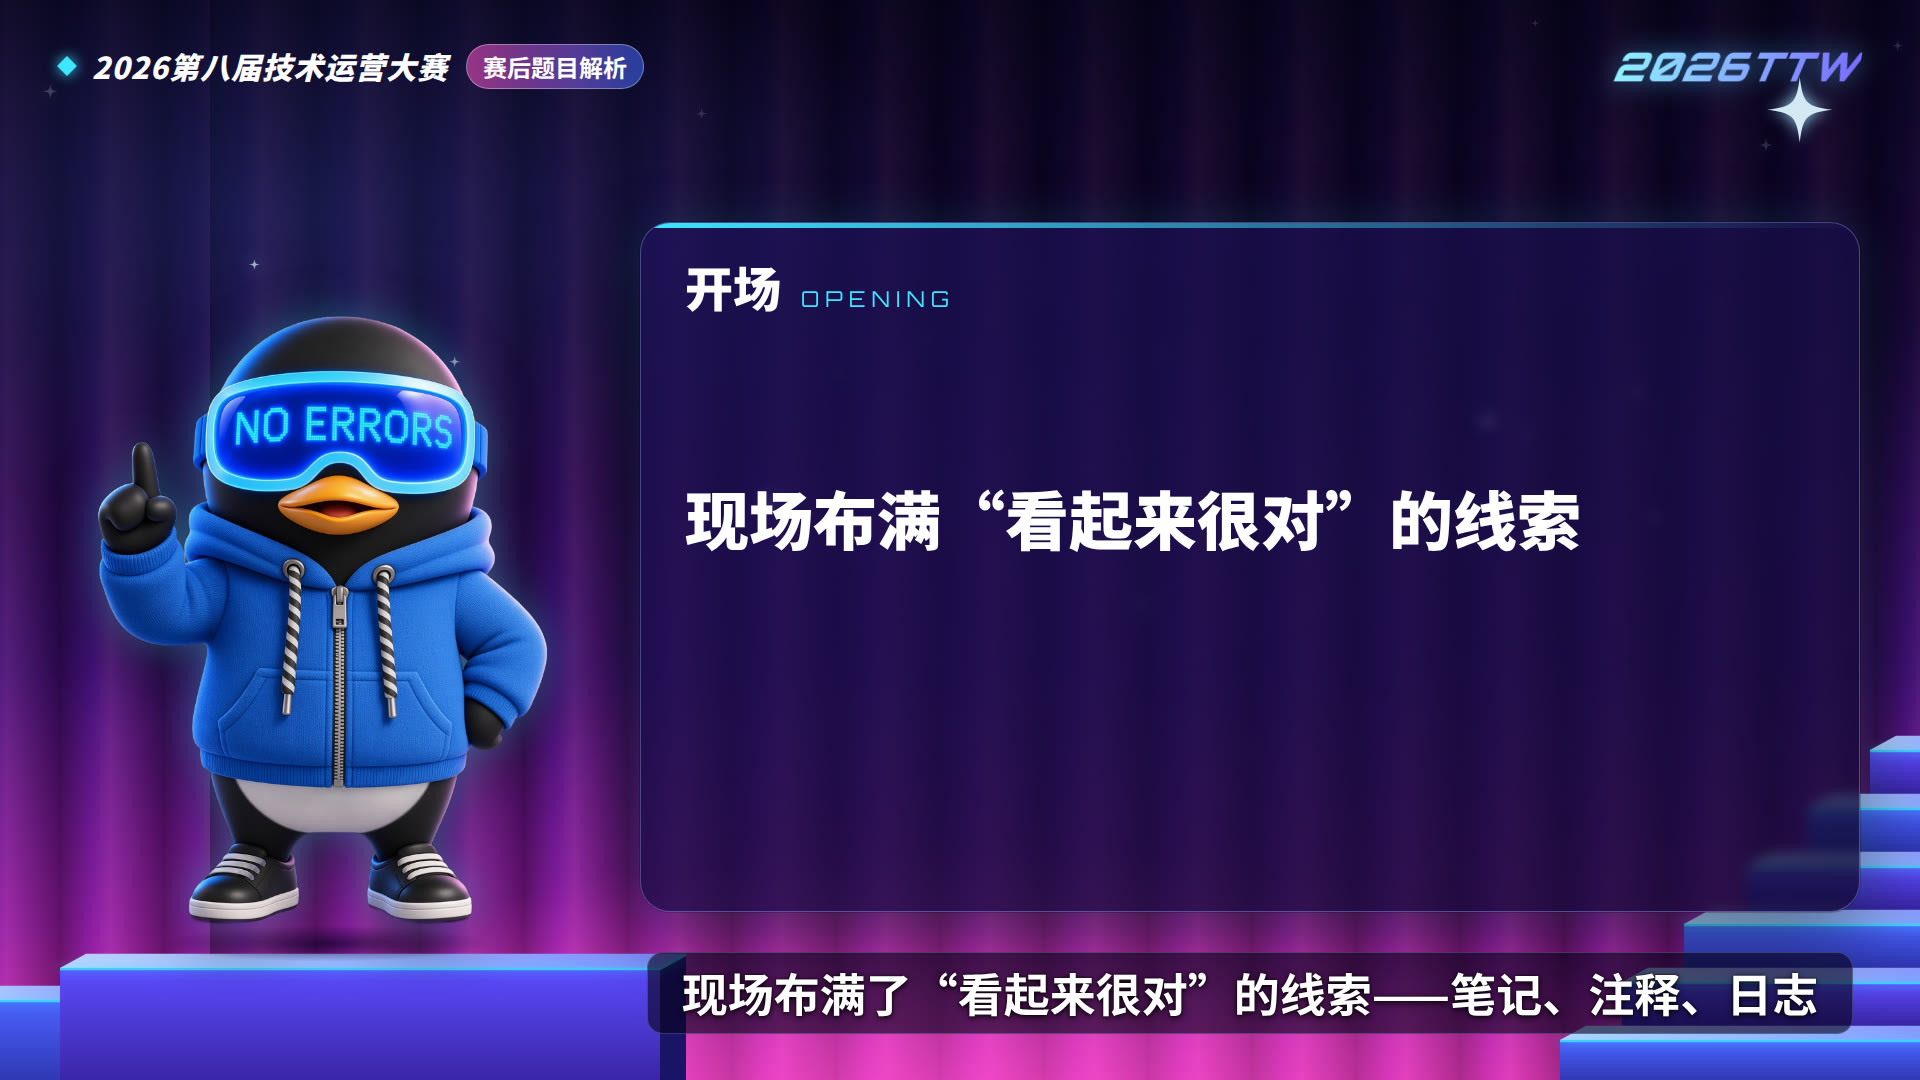 |
| 陷阱在哪:四层拉起链 | 正确思路:终端演示 |
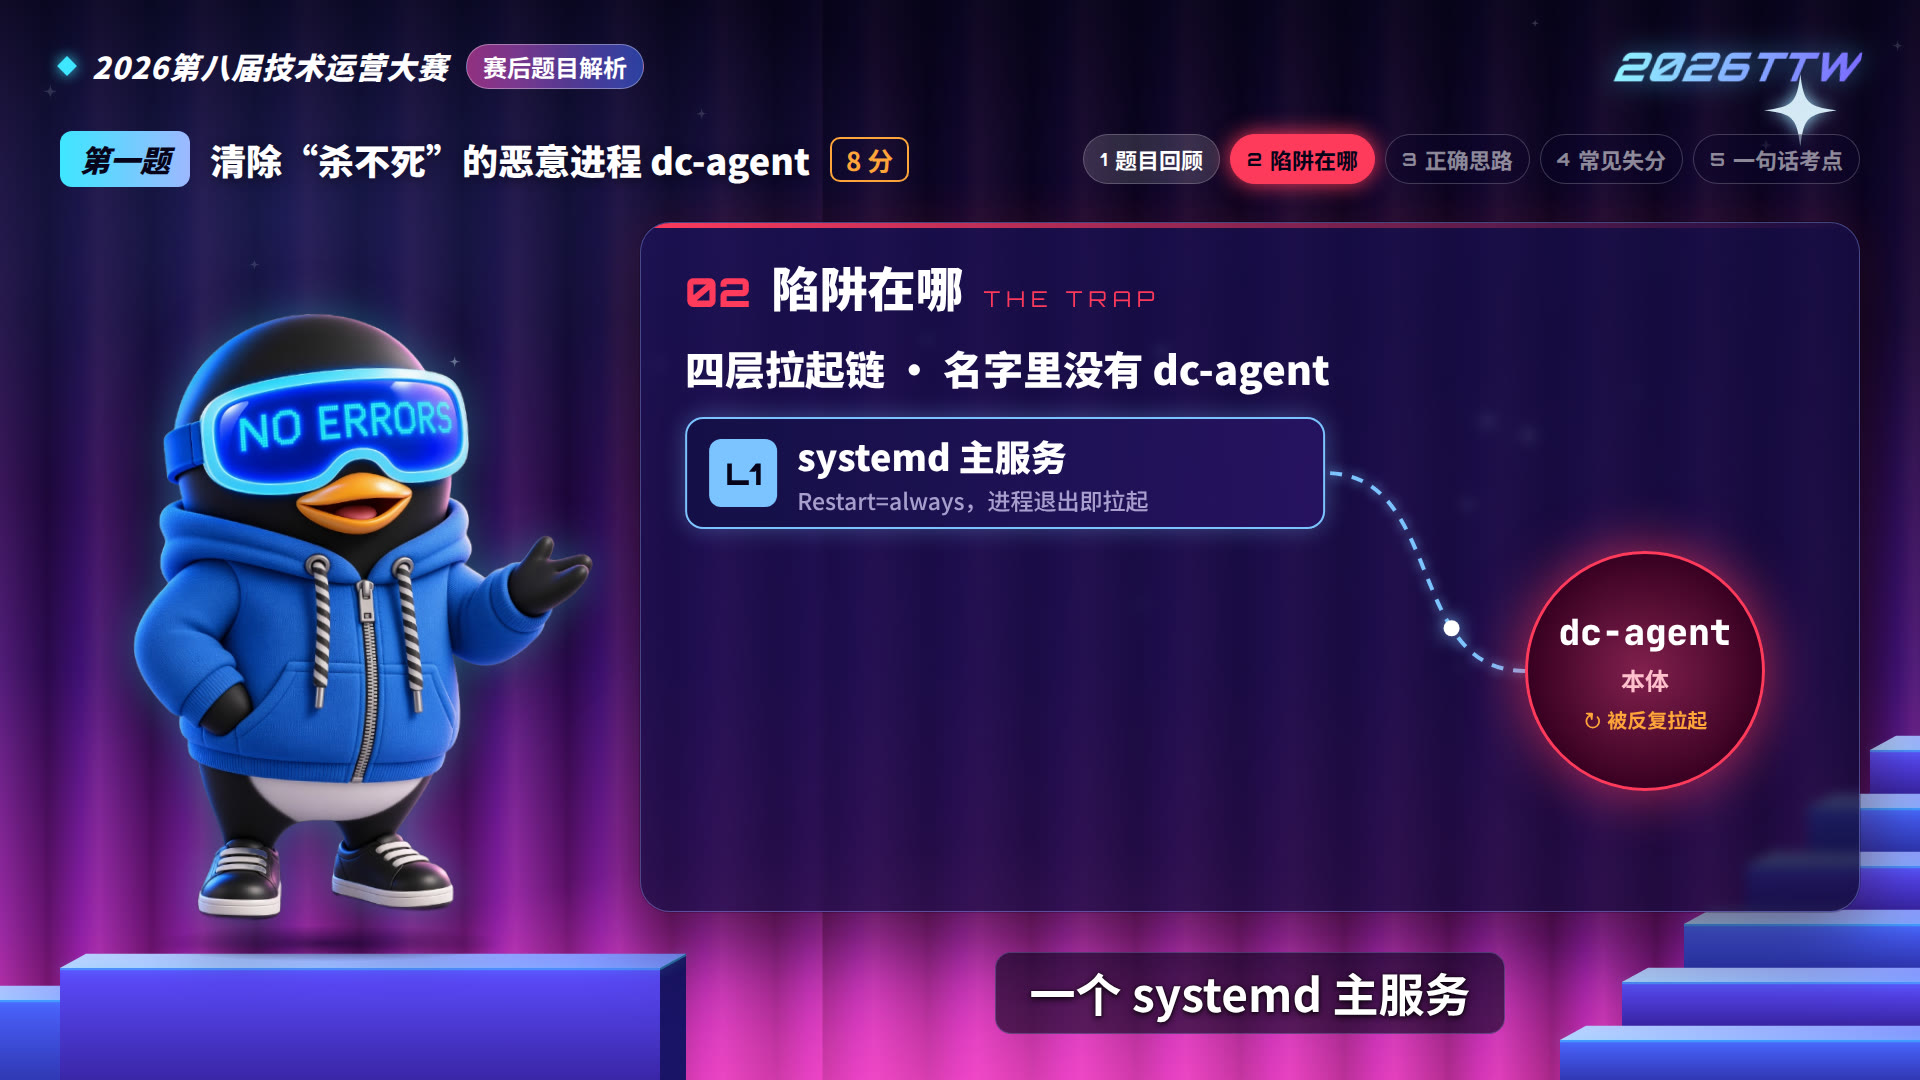 |
 |
| 常见失分 | 一句话考点 |
 |
 |
10.2 输入:一张海报 + 一段朗读稿
素材只有大赛的主视觉海报:
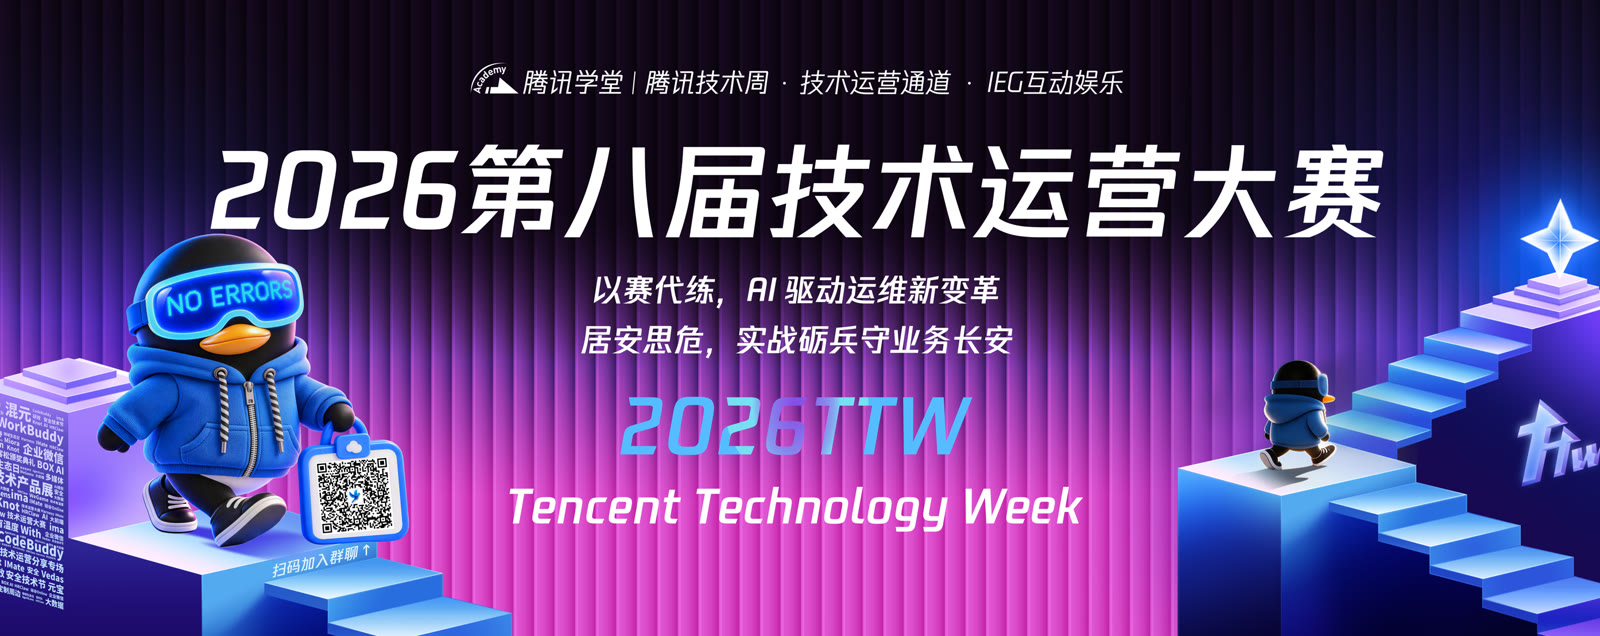
和这样一条消息(朗读稿较长,这里折叠了第一题的细节):
我的目标是利用以上这些视觉元素(特别是那只企鹅),去构建《技术运营大赛》的短片,
用来进行主持和题目的讲解,替代掉主持
————————————————
2026 运维操作赛 · 赛后题目解析(主持人朗读稿)
使用说明:每道题按"题目回顾 → 陷阱在哪 → 正确思路 → 一句话考点"组织,每题约 1~2 分钟。
命令名尽量口语化,括号里的内容可读可不读。

开场
各位选手,大家辛苦了!比赛已经结束,接下来我们用十几分钟时间,把今天的十道操作题逐一过一遍。
今天的题目有一个共同特点:现场布满了"看起来很对"的线索——笔记、注释、日志、grep 结果,
很多都是故意放的干扰。能拿高分的选手,靠的都是同一个习惯:不信表象,以实测为准。
下面我们一道一道来看。

第一题:清除"杀不死"的恶意进程 dc-agent(8 分)
题目回顾:……
陷阱在哪:……
正确思路:……
常见失分:……
一句话考点:……
注意这条消息里没有提 Remotion,也没有说怎么做。用什么工具、画面长什么样、配音怎么来,都是它自己定的。
主 Agent 收到后先回了一段思路,然后直接开工:
主持人:用 KV 里那只戴 NO ERRORS 护目镜、穿蓝色卫衣的企鹅,会做简单动画(晃动、说话、手势),整体沿用主视觉的紫粉渐变配霓虹台阶。 配音和字幕:中文 TTS 配音,严格按你的朗读稿念,字幕直接烧进画面。 每道题的画面:按"题目回顾 → 陷阱在哪 → 正确思路 → 常见失分 → 一句话考点"切换信息卡,配终端风格的命令片段。第一题会单独画一张四层拉起链的示意图。 技术方案:用代码生成视频(Remotion),脚本放在数据文件里,后面九道题只要补文字就能重新渲染。
10.3 过程:worker 是怎么做出来的
第一步,做出会说话的企鹅。 海报里的企鹅只有一个姿势,没法「主持」。它先照着海报生成了 4 个姿势(待机、讲解、提醒、点赞),每个姿势各一张张嘴、一张闭嘴:
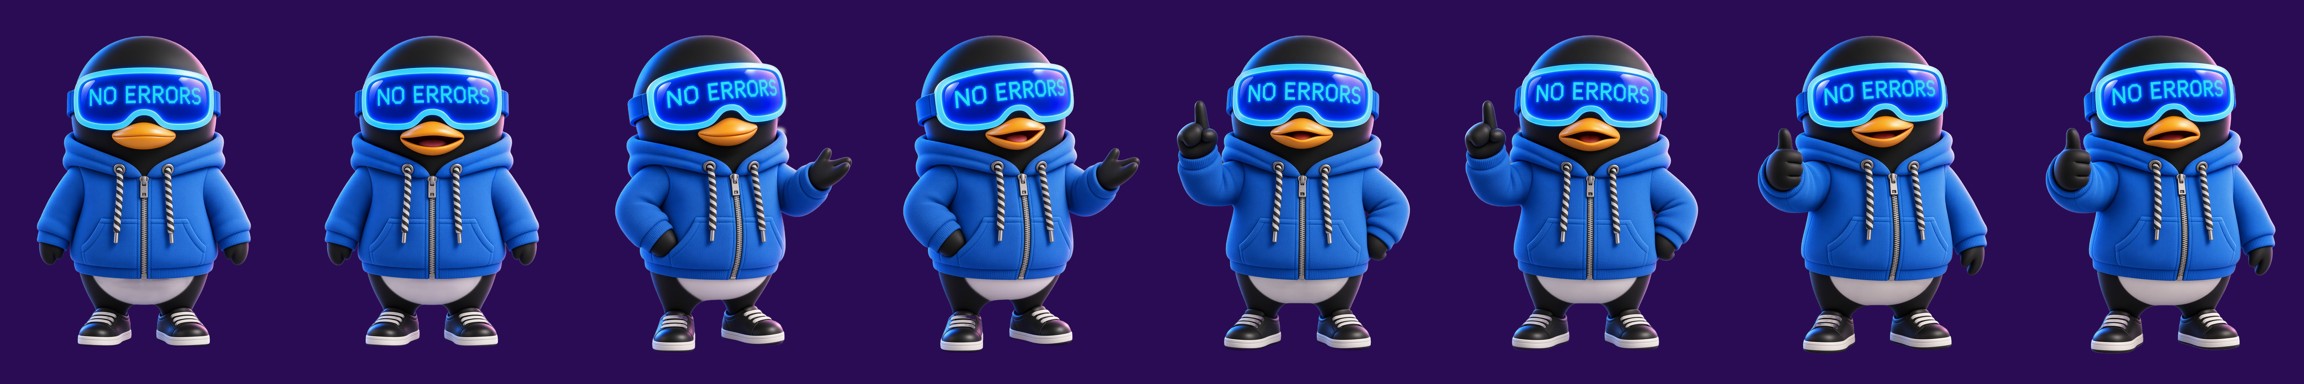
然后用 rembg 抠掉背景,并且只把张嘴图的「嘴部区域」贴到闭嘴图上,保证两帧逐像素对齐,切换时不会抖。播放时按配音每一帧的音量决定张嘴还是闭嘴,就有了口型。
第二步,把朗读稿变成数据。 所有内容放在一个 content/script.json 里,配音和画面都从这里读。每句旁白配一个企鹅姿势;每张卡片带一个 cue,旁白念到这几个字时卡片才出现。下面是「陷阱在哪」这一段的节选:
{
  "kind": "trap",
  "lines": [
    { "id": "q1-trap-1", "pose": "warn", "text": "陷阱在哪:如果你执行 grep dc-agent 去找,会搜出几十个文件——但它们全是诱饵。" },
    { "id": "q1-trap-2", "pose": "present", "text": "真正负责拉起它的四层机制,名字里一个 dc-agent 都没有:……" }
  ],
  "visuals": [
    {
      "type": "chain",
      "cue": "真正负责",
      "title": "四层拉起链 · 名字里没有 dc-agent",
      "target": "dc-agent 本体",
      "layers": [
        { "name": "systemd 主服务", "detail": "Restart=always,进程退出即拉起", "cue": "systemd 主服务" },
        { "name": "伪装成 ktune 的拉起脚本", "detail": "名字像内核调优工具,实为守护循环", "cue": "伪装成" },
        { "name": "脱离会话的看门狗", "detail": "setsid 脱离终端,父进程 PID = 1", "cue": "看门狗" },
        { "name": "每分钟触发的 timer", "detail": "OnCalendar=*:0/1,兜底重建一切", "cue": "timer" }
      ]
    }
  ]
}
朗读稿里只有文字,「grep 搜出 47 个文件全是诱饵」的终端画面、四层拉起链的示意图、被划掉的错误笔记,都是它根据讲解内容自己设计的。它还准备了一份发音表,只给语音合成用,字幕保留原文。比如 systemctl 读成「system C T L」,10 秒 读成「十秒」。
第三步,配音。 这是这一步里唯一卡住的地方:
- 我先给了一组腾讯云的 Key,它测出这个子账号只有语音识别权限,没有语音合成权限,并告诉我要在 CAM 里补哪几个权限;
- 我又给了一个火山方舟的 Key,它测出这个 Key 能调 135 个模型,但豆包语音合成不在它的调用范围内;
- 备用的 edge-tts 在云端机器上也连不上。
它没有停下来等,而是换成了能在本地离线运行的 Kokoro 中文语音先把第一版做完,同时把配音写成可切换的流水线:豆包 → 腾讯云 → edge-tts → Kokoro,哪个能用就用哪个。拿到能用的 Key 后只要重跑配音、重新渲染,不用改代码。它还专门检查了 systemctl、pkill、timer 这些命令名念得准不准。
第四步,字幕对齐。 字幕按标点切分,但不会从引号中间断开;时间先按语速估算,再吸附到音频里检测到的停顿上。
第五步,自查后交付。 渲染前先截了片头、开场、陷阱、终端、失分、考点 6 张预览图;渲染完每隔 6 秒抽一帧检查中文字体、字幕同步和画面裁切。交付时它还主动说明了两点不足:Kokoro 念英文命令带口音;终端里的服务名(如 sysperf.service)是按「名字里没有 dc-agent」虚构的,给它真实名字就能替换。
10.4 后来又做了什么
第一版之后的迭代就不是 one-shot 了,简单列一下,方便你看完整的走向:
- 换成豆包语音合成「天才童声 2.0」重新配音;
- 把比赛口号「AI 能力无上限,古法手搓有底线」加进片头和开场;
- 第一题换成比赛里的真实服务名;
- 主 Agent 把剩下的九道题拆给 3 个 worker 并行制作,最后合成 12 段分段视频和一版完整片,推到私有 GitHub 仓库。
10.5 这个案例说明了什么
- one-shot 的前提是输入完整:目标(替代主持)、视觉素材(海报)、内容(朗读稿)都在一条消息里,它就不需要来回问。
- 结构化的稿子就是分镜:朗读稿本身分好了「题目回顾、陷阱在哪……」,它直接变成了画面上的章节切换。
- 卡住时它会先交付能用的版本:配音 Key 不可用,它没有停工,而是用离线语音先出第一版,把「换声音」留成一个随时可做的步骤。
- 后续扩展很便宜:数据驱动的结构,让补九道题变成「往 JSON 里加内容」。
11. 实战案例二:两分钟的 e/acc 纪录片
案例一和前面的产品短片,画面都是「自己画的」。这一节换个难一点的题目:让 Opus 5.5 抓取真实的名人访谈片段,剪成一支电视纪录片风格的短片。下面是完整记录:提示词、过程、踩的坑和成品。代码在 eacc-documentary/。
11.1 成品
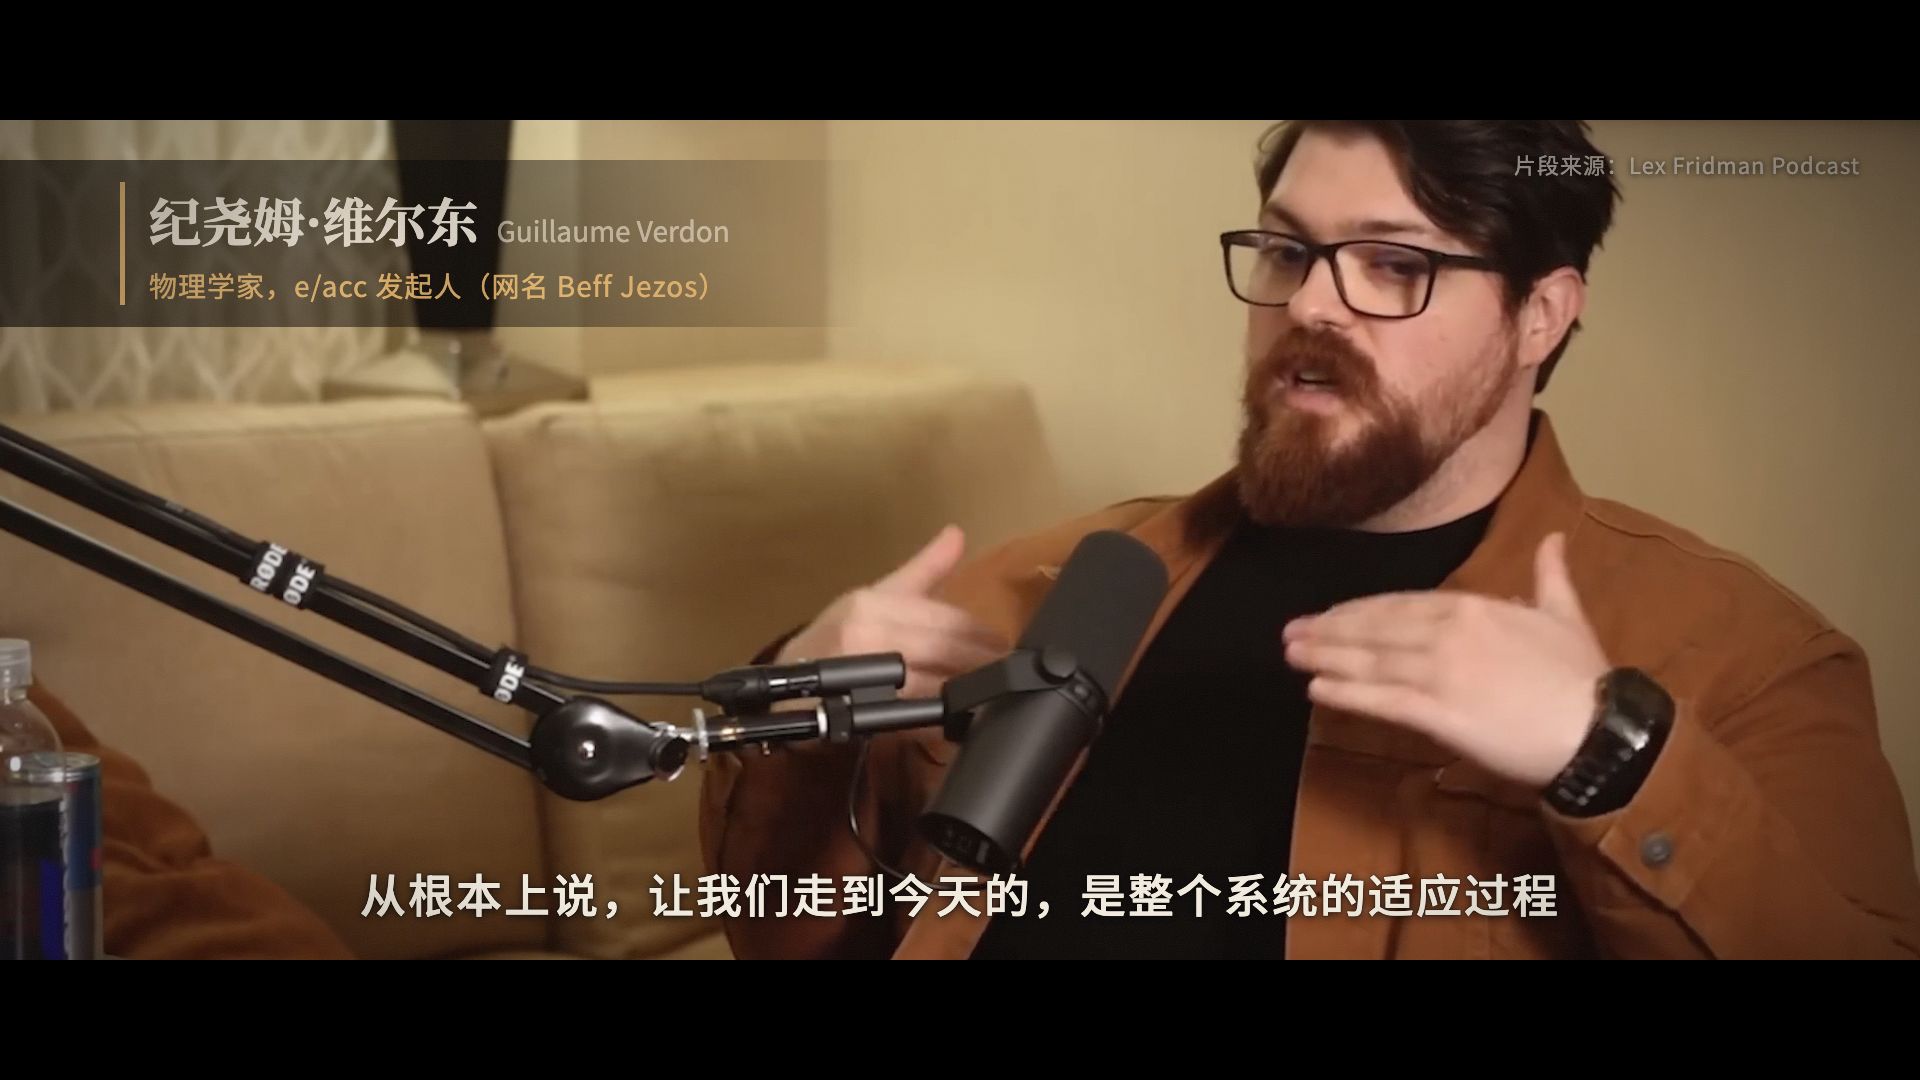
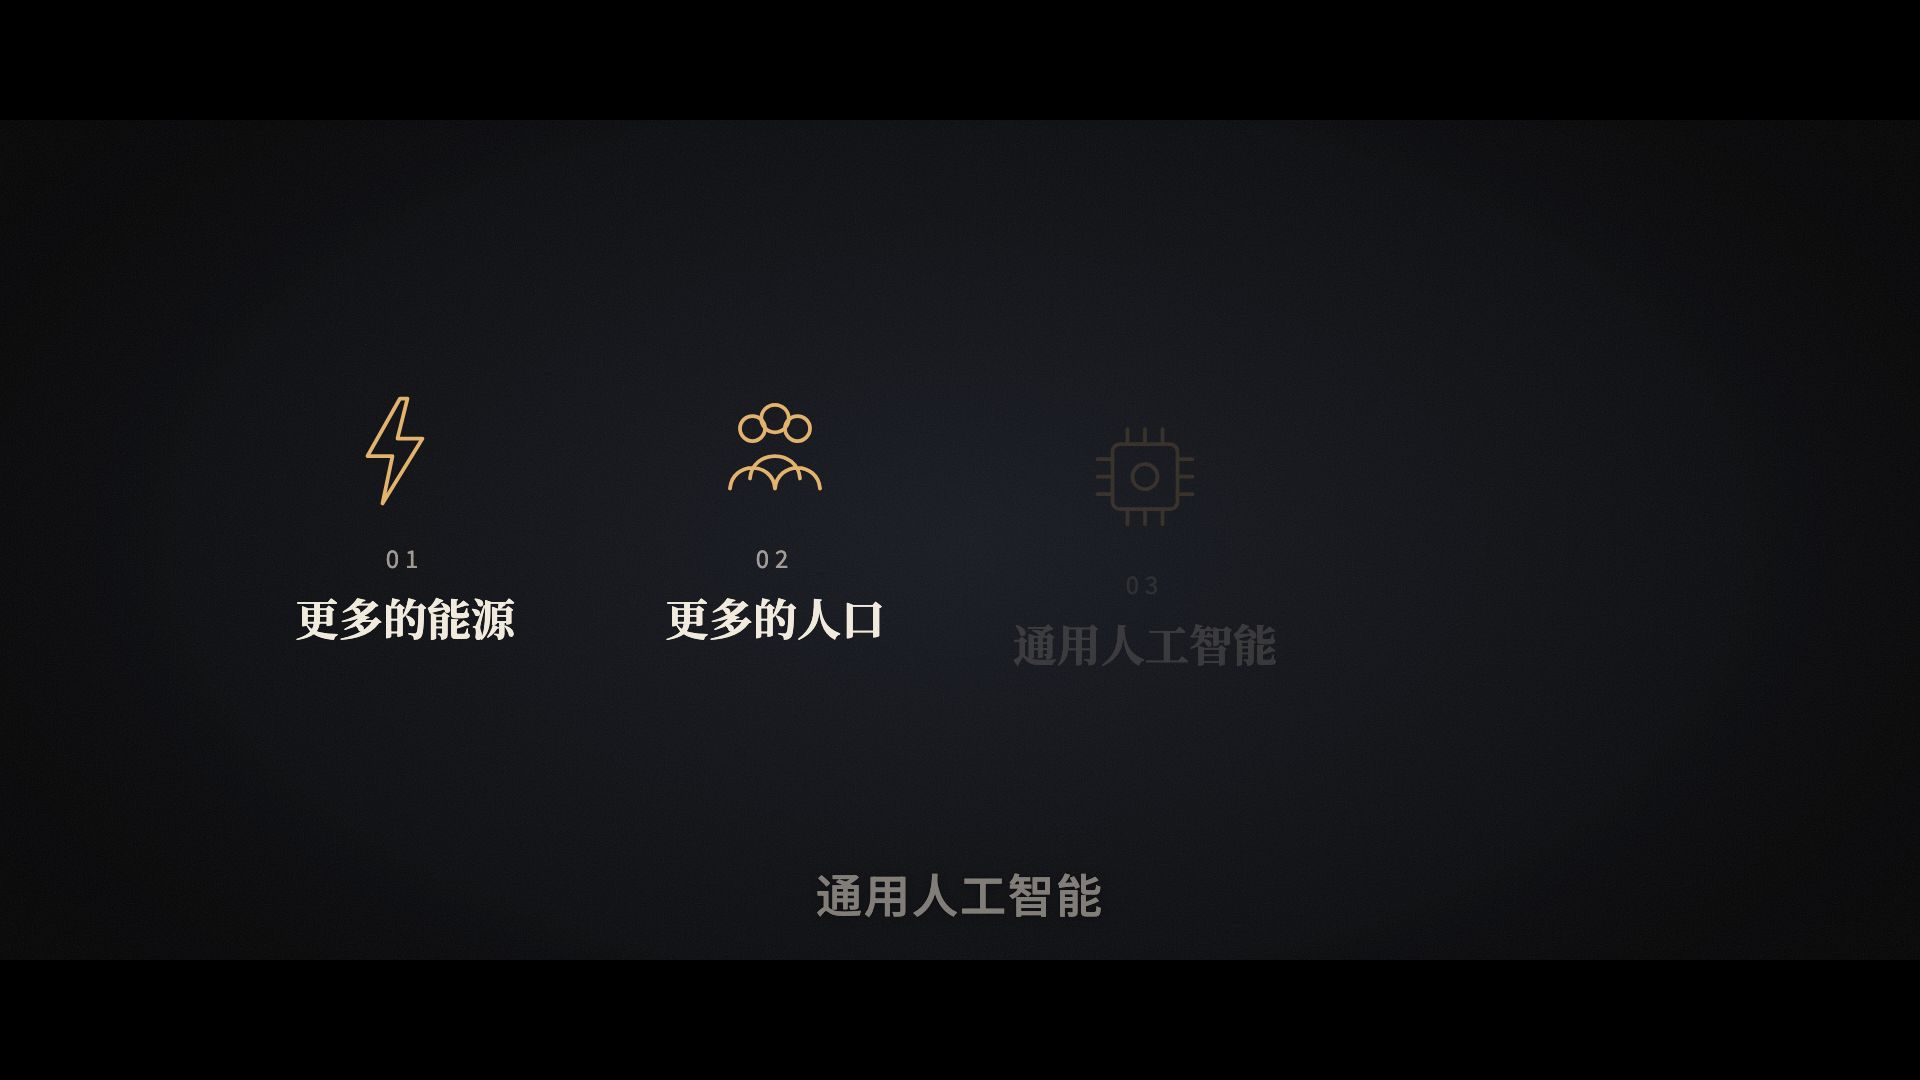
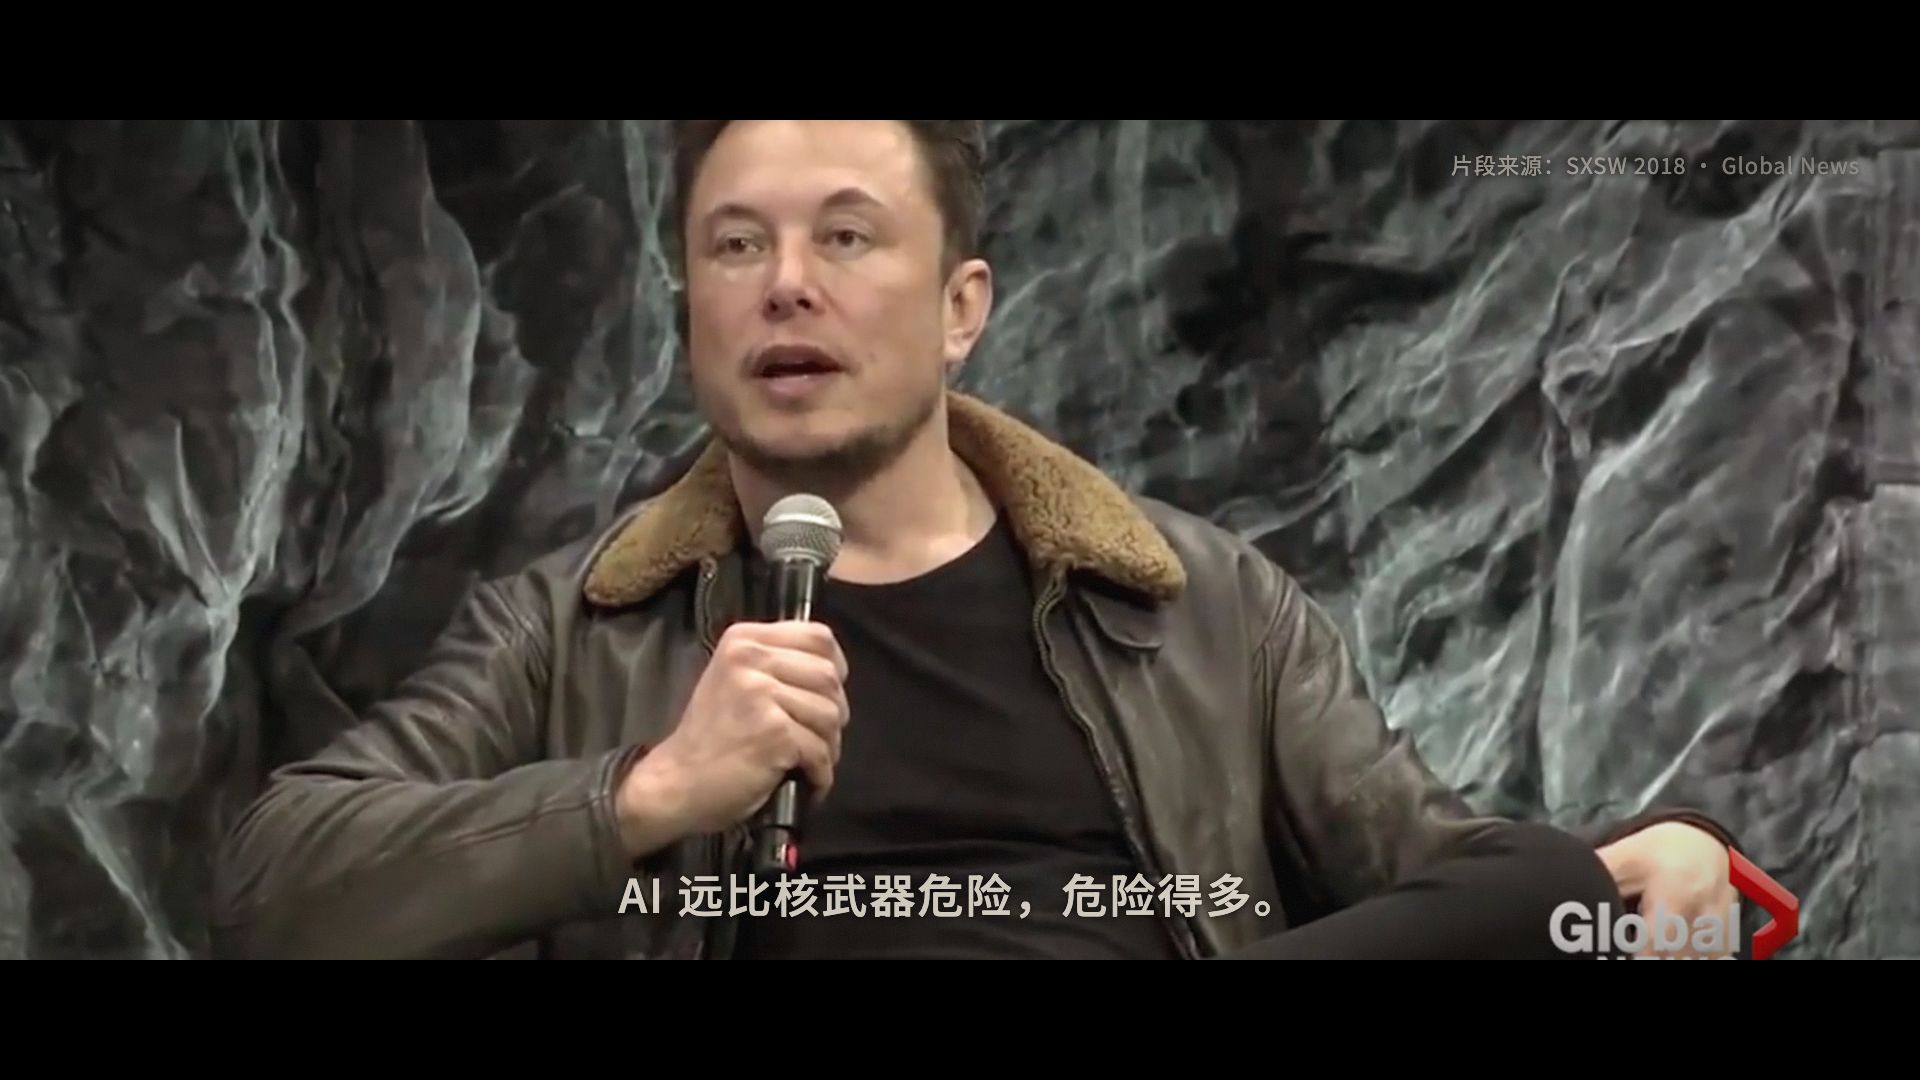
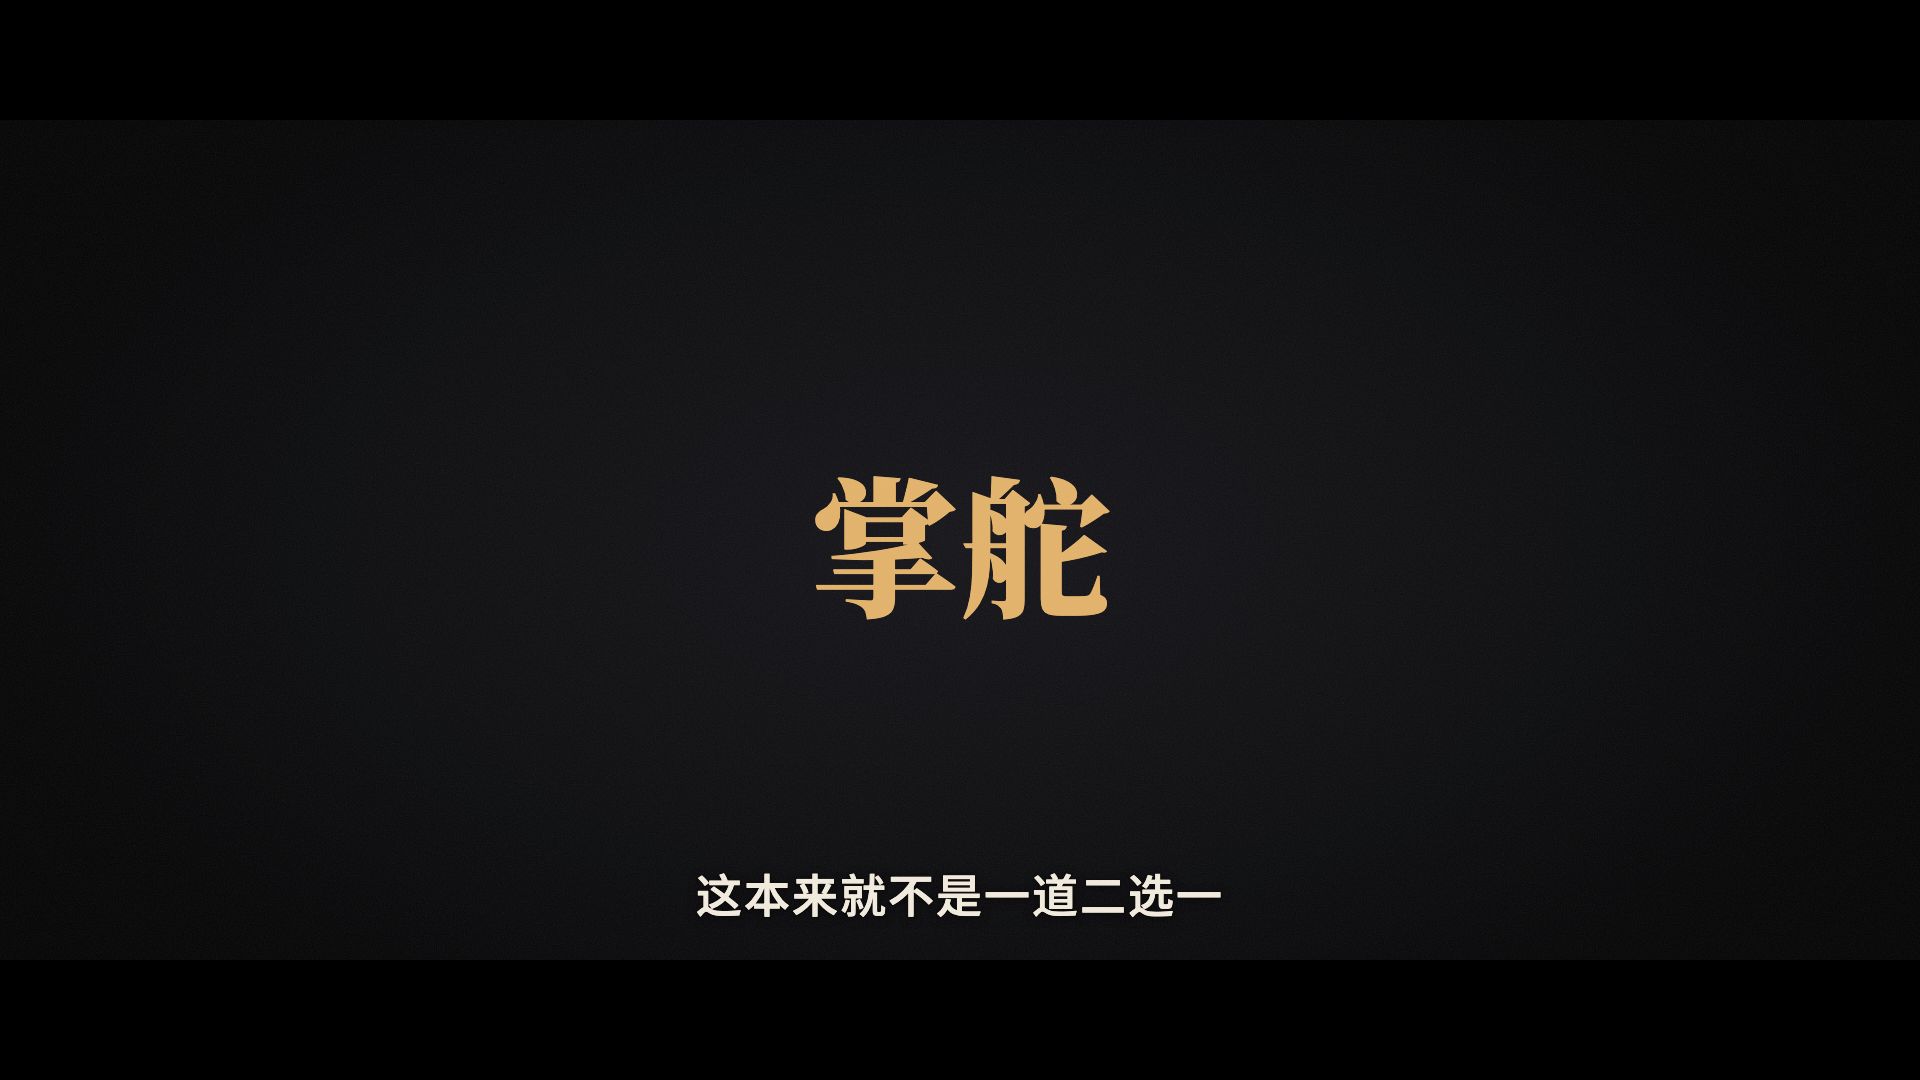
一支 2 分 24 秒、1920×1080 的短片:中文旁白、中文字幕、人名条、章节标题、宽银幕黑边和胶片颗粒,穿插 9 段名人原话。
| 名人原话 + 人名条 | 动画讲概念 |
|---|---|
 |
 |
 |
 |
11.2 提示词
最初只发了这么一段:
用电视纪录片的风格解释一下什么是 e/acc:
• 把一些名人的片段抓下来剪辑好
• 加上字幕,配上比较专业的配音
• 时长大概 2 分钟
• 要求给人希望
之后 Opus 5.5 问了几个它自己定不了的问题,我只需要点选:
| 它问的问题 | 我的选择 |
|---|---|
| 配音和字幕用什么语言? | 中文配音 + 中文字幕,英文原话配中文字幕 |
| 配音用哪家? | 豆包语音合成 |
| 名人片段从哪里来? | 它自己去 YouTube 找 |
| 内容取向?(它提醒:e/acc 争议很大,纯正面容易像宣传片) | 保持批判思考 |
| 用什么方式制作? | Remotion |
看完它给的方案,我追问了一句「没有 Elon Musk 吗?」,它就去补了马斯克的片段,并调整了结构。整个过程里我做的事情就这些:回答问题、给豆包的 Key、允许它读取浏览器里的 YouTube 登录状态。
11.3 它定的片子结构
| 段落 | 内容 |
|---|---|
| 序章 · 加速 | 旁白:人类文明的每一次跃升,都来自驾驭能量的能力 |
| 一 · 什么是 e/acc | 发起人维尔东(Guillaume Verdon)亲口讲核心论点;动画列出四个目标 |
| 二 · 赌注 | 马斯克:「我们要把人类带到火星」;安德森:「这是有史以来最好的一件事」 |
| 三 · 矛盾 | 马斯克:「AI 远比核武器危险」;辛顿:「人类知道自己在做什么吗?不知道」;维尔东反驳:「安全是集中权力的完美掩护」 |
| 四 · 选择 | 安德森:「我不是乌托邦主义者」;结尾:未来不是等来的,是造出来的,也是选出来的 |
这个结构是它根据「给人希望」和「保持批判思考」两个要求自己权衡出来的:正反两方都让当事人亲口说话,结尾给的是有分寸的希望。它还主动提醒了一点:马斯克从没公开自称 e/acc,旁白只能说他「目标和 e/acc 最接近、对 AI 却最警惕」,不能给他贴标签。
11.4 过程:它是怎么做出来的
第一步,找原话。 它用 yt-dlp 在 YouTube 上搜索访谈,先只下载自动字幕,在字幕里定位原话,再决定要哪几段。最后选定 4 个来源:Lex Fridman 播客(维尔东、安德森)、SpaceX 官方视频、SXSW 2018(马斯克)、CBS 60 Minutes(辛顿)。
第二步,绕过下载限制。 这里踩了两个坑,都是它自己排查出来的:
- YouTube 要求「登录验证不是机器人」。升级 yt-dlp、换客户端都没用,它判断是 IP 被限制,于是问我能不能用 Chrome 里的登录状态(
--cookies-from-browser chrome)。 - 过了验证又报「拿不到视频格式」:新版 YouTube 要先执行一段 JavaScript 解签名,它给 yt-dlp 加上
--js-runtimes node,借用本机的 Node 解决了。
第三步,精确剪辑。 它只下载需要的几十秒(--download-sections),再用 whisper 做逐词时间戳,把每句原话的起止精确到 0.1 秒。辛顿那句「人类知道自己在做什么吗?不知道」被背景音乐盖住,第一次没识别出来,换成更大的 large-v3-turbo 模型才找到。
第四步,检查画面。 它把每段素材每秒抽一帧拼成长条图来看,发现安德森说「最好的一件事」时,镜头一直对着主持人。于是改用纪录片的常见做法:原声不变,画面换成安德森的静帧缓慢推近,避免人名条贴在别人脸上。
第五步,挑配音。 它用开场旁白给 7 个豆包男声各生成一段试听。它自己听不见声音,就算了每个音色的平均音高,挑了最低沉的 zh_male_m191_uranus_bigtts(约 101Hz),语速调慢一点,更像纪录片旁白。
第六步,用 Remotion 搭起来。 和前面的产品短片一样,文案和画面分开。所有内容写在 src/script.json 里,旁白和原话交替排列,每段原话记下裁剪位置、中文字幕和人物信息:
{
  "type": "clip",
  "id": "musk_nukes",
  "person": "musk",
  "source": "SXSW 2018 · Global News",
  "from": 7.8,
  "to": 13.95,
  "subtitles": [
    { "start": 0.1, "end": 1.9, "text": "记住我的话," },
    { "start": 2.0, "end": 6.1, "text": "AI 远比核武器危险,危险得多。" }
  ]
}
组件按职责拆开:胶片质感(黑边、颗粒、暗角)、字幕、人名条(人物第一次出镜时出现)、章节标题、静帧推近,以及几个用代码画的概念动画(地平线亮起的灯光、四个目标、「加速」和「刹车」合成「掌舵」、日出)。背景音乐会自动避让:旁白时压低,名人原话出现时压到更低,片尾再放开。
第七步,检查和渲染。 渲染前它先截了十几个关键帧检查,发现人名条的金色小字在米色背景上看不清,就加了一层深色渐变底。整片 4314 帧,渲染用了约 3.5 分钟。
11.5 几点提醒
- 版权:名人访谈片段有版权。自己学习、内部分享问题不大;公开发布前要评估风险,本片每段只截了 2 到 17 秒的原话,并在画面上标注了出处。
- 字幕时间是估算的:豆包不返回逐字时间戳,旁白字幕按字数和标点估算,个别地方可能有轻微偏差。
- 配乐是占位:这支片子的背景音乐是代码合成的氛围铺底,配好豆包音乐的 AK/SK 可以换成真实配乐。
- 把关还得靠人:AI 能看画面、算音高,但听不见声音。音色、节奏、混音是否舒服,最后要你自己听一遍。
12. 进阶:风格拿不准、或者想更可控时,试试 Lemo-Opuscar
前面的例子里,风格都是一句话带过的:「深色科技风」「电视纪录片风格」。Opus 5.5 会自己发挥,效果往往不错,但有两种情况光靠一句话不够:
- 你还没想好视频该长什么样,说不出具体风格;
- 你想让风格更可控:每次做出来都是同一种调性,配色、字体、节奏、镜头语言不要每次都变。
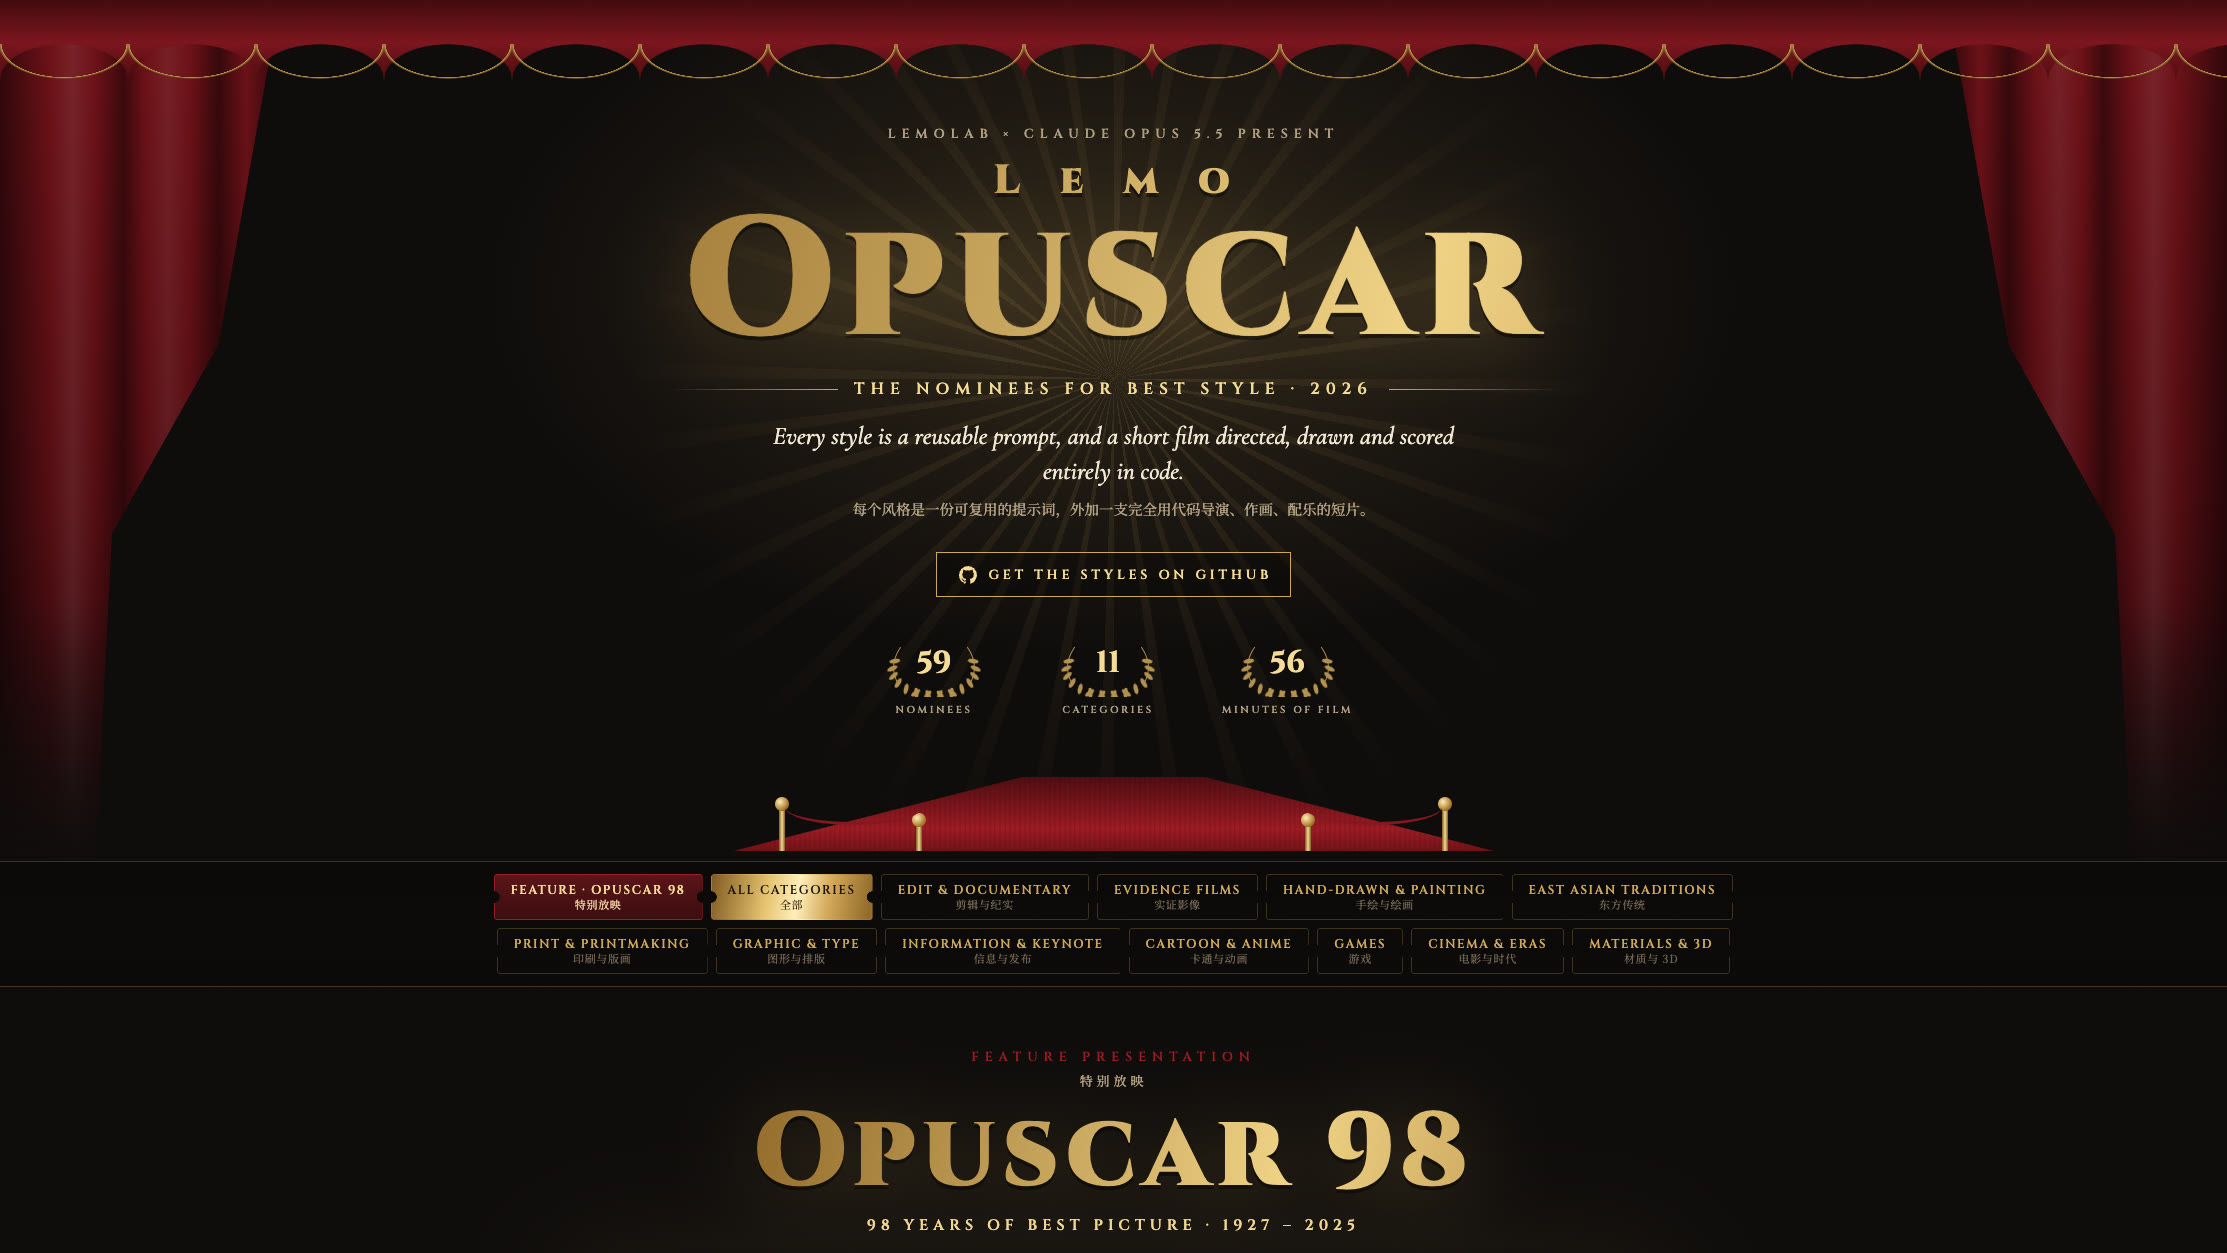
这时可以用 Lemo-Opuscar。它是一套「用代码做片」的风格工具箱,以 Agent Skill 的形式提供,收录了 59 种现成风格,并且是专门按 Claude Opus 5.5 调出来的。每种风格都有一支示范片,外加一份写给 agent 看的风格说明(STYLE.md),把「这个风格长什么样、听起来什么样」写得很具体。agent 照着说明做,风格就不再靠它临场发挥。
不知道选什么:先看风格图鉴
打开它的 风格图鉴,像逛画廊一样挑一个顺眼的,然后报风格名就行。风格按「剪辑与纪实」「信息与发布」「手绘与绘画」等 11 个分类排好,每张卡片都能直接播放示范片:
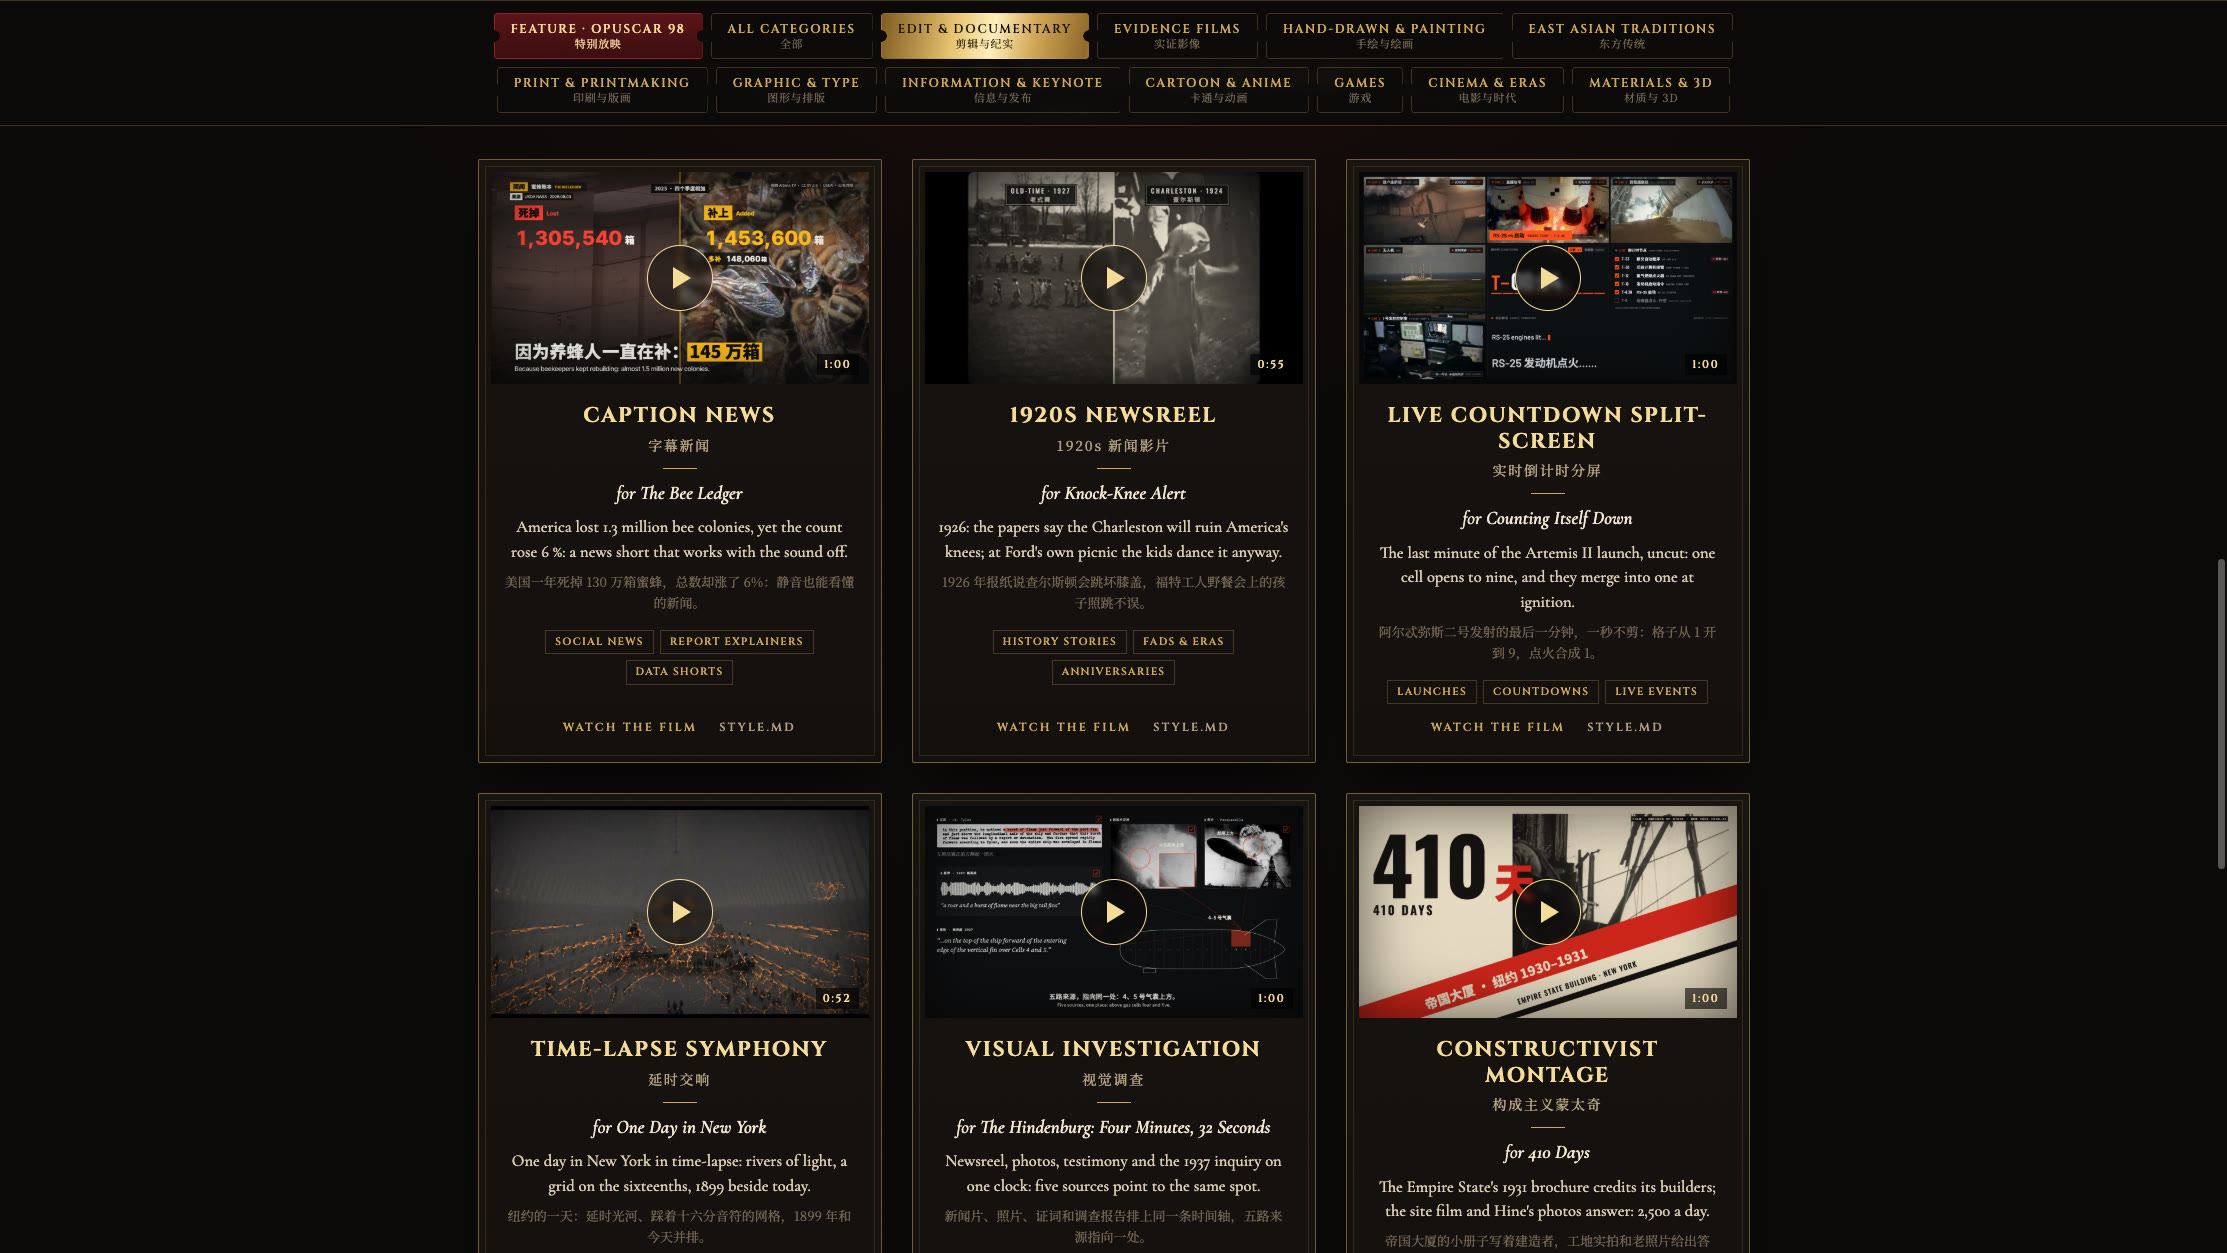
比如 字幕新闻(Caption News)风格,属于它的「剪辑与纪实」分类:用大字幕把一条新闻讲清楚,关掉声音也能看懂,很适合大家习惯静音刷视频的平台。说一句:
用字幕新闻风格做一支 40 秒的片子,讲 Remotion 新版的共享内存捕获怎么让渲染变快。
下面是这个风格的示范片《The Bee Ledger》:美国一年死掉 130 万箱蜜蜂,总数却涨了 6%。可以试试静音看:
同一个分类里还有 1920s 新闻影片、电视新闻包装、视觉调查等风格,做资讯类、复盘类视频时都可以翻一翻。
如果是本文这种产品介绍片,可以看看「信息与发布」分类里的 暗色科技发布(Dark Tech Keynote),示范片是一个虚构 app 的发布片:
想更可控:把风格改成你自己的
如果你有自己的品牌色、logo、字体或账号调性,它还支持「改成你自己的风格」:在库里某个风格的基础上改配色、字体、节奏、声音,或者从空白描述一个新风格。它会先出一张风格图、再出一支 15 到 30 秒的 demo 片,你满意了才保存。保存后的风格放在 ~/lemo-my-styles/,以后做片直接叫它的名字,每支片子的调性就能保持一致。
它自己给的例子:以库里的 瑞士动态排版(平面网格、一个信号色、动作卡着节拍)为底子,保留网格、节拍和字体,把平面图形换成陶土、塑料、绒布、玻璃和铬的实物,做成了新风格「材质网格」。左边是原风格,右边是改出来的版本:
库里的风格:瑞士动态排版 |
改出来的风格:材质网格 |
怎么装、用之前要知道什么
- 安装:Claude Code 用户两条命令装成插件:
claude plugin marketplace add lemomo-ai/lemo-opuscar,再claude plugin install lemo-opuscar@lemolab。在 Cursor 或 Codex 里,把仓库的plugin/skills/lemo-opuscar/复制到项目的.agents/skills/目录。 - 它有自己的一套做法:画面用 Canvas 和 WebGL 逐帧渲染,不走本文的 Remotion 流程。可以把它当成「换一种风格重新做一支」,也可以只借它的
STYLE.md,让 Opus 5.5 在 Remotion 里照着做。 - 比较费时:官方说一支片子 agent 大约要做 30 到 60 分钟,token 用量也不小。
本节的示范片和截图来自 Lemo-Opuscar,© LemoLab,按 CC BY 4.0 授权使用;为了控制文章体积,视频已压缩为 720p。
总结
- 建项目,装 Remotion skills;
- 把火山引擎的 Key 放进
.env; - 一句话说清楚要什么视频,Opus 5.5 负责写画面、接配音、接配乐;
- 在 Studio 里看,一句话一句话地改;
npm run render出片,新版 Remotion 自动加速。
完整代码在 remotion-demo/,npm install && npm run dev 就能打开。想看真实项目怎么做,见第 10 节(一条消息做出比赛解说短片)和第 11 节(抓取名人素材剪成纪录片);风格拿不准或想更可控,见第 12 节。
课外读物
Opus 5.5 视频合集:看别人一句话做出了什么
Opus 5.5 videos: viral prompts and live remakes
别人用 Opus 5.5 做出来的视频合集(四百多支),每支都附了创作者用的原始提示词,以及用同一条提示词重新生成的对照版本。想看「一句话能做出什么样的视频」,可以从这里翻。
video-shotcraft:给 Remotion 用的「镜头配方库」
video-shotcraft 是一个给 Claude Code 和 Codex 用的 Agent Skill,专门做产品宣传片,底层用的就是本文讲的 Remotion,可以看成本文流程的「专业加强版」。
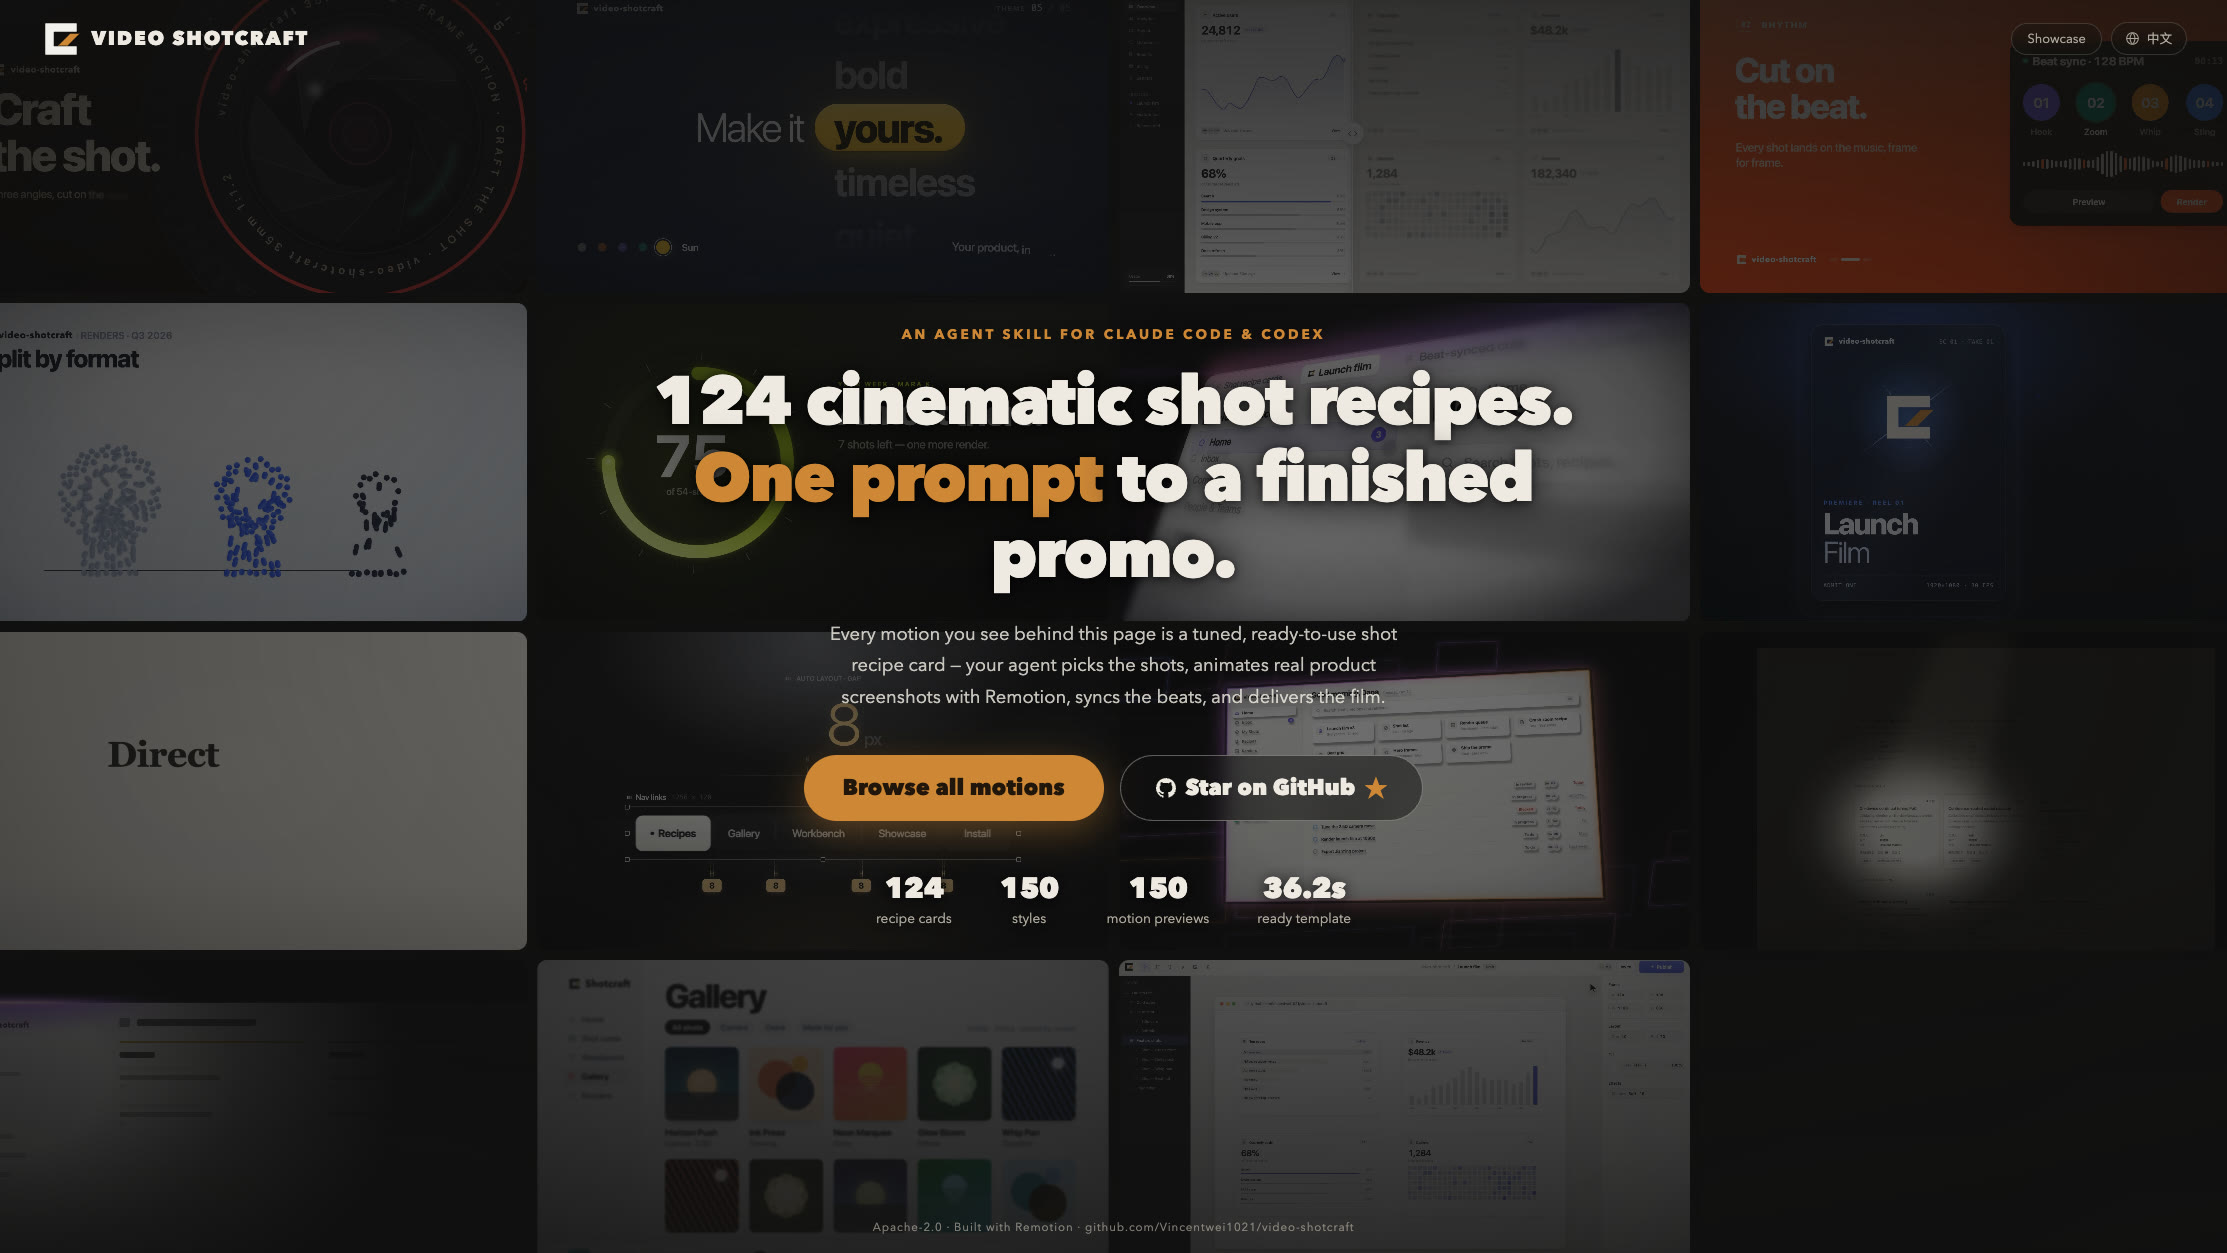
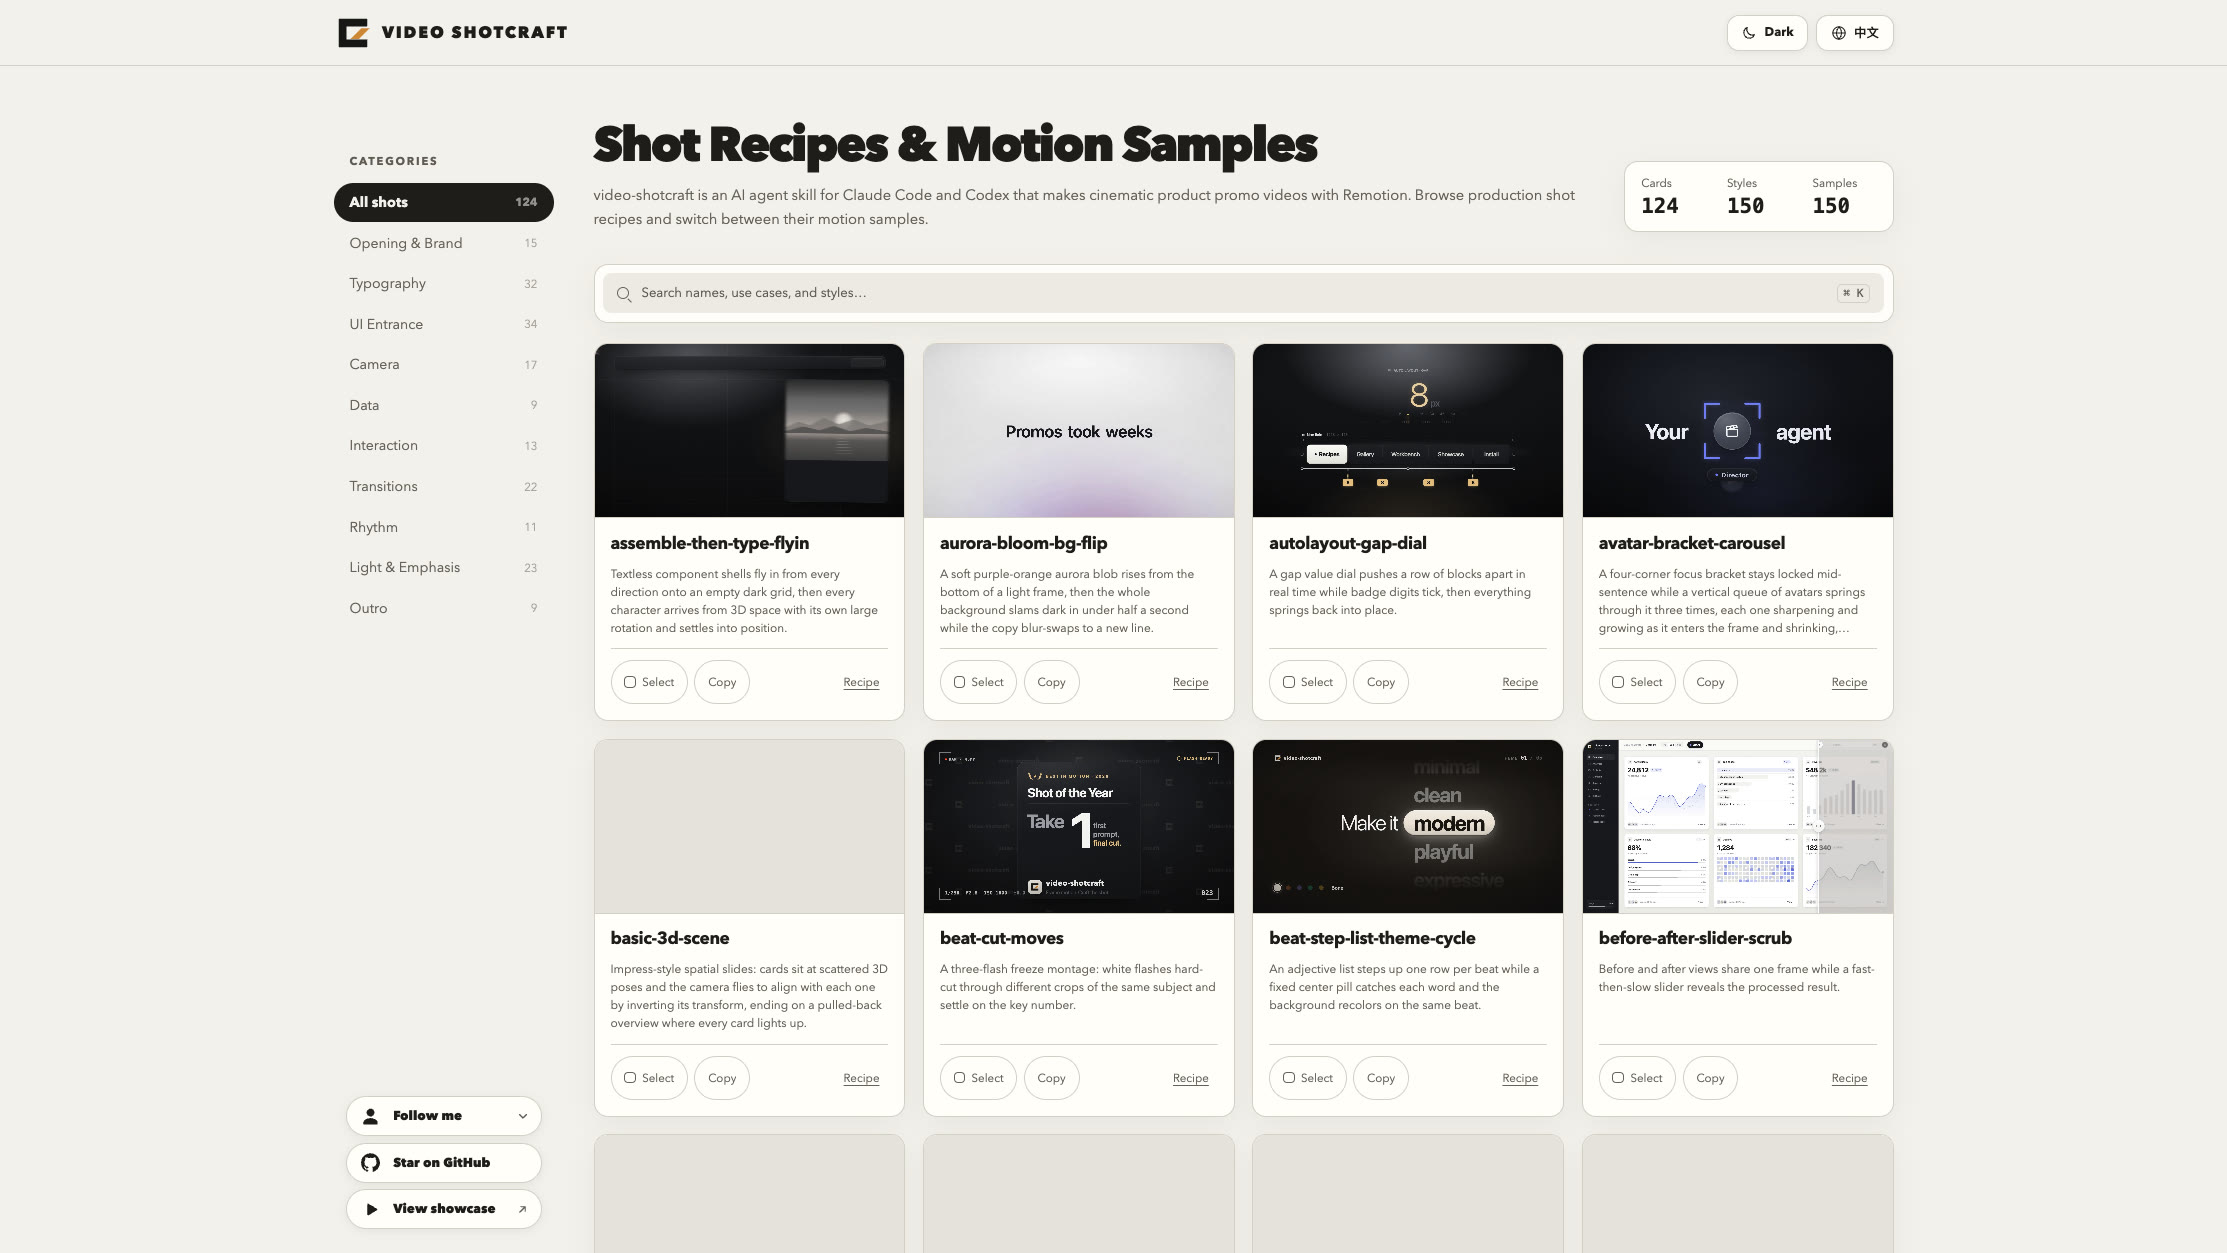
它解决的是「动效不够高级」的问题。我们让 Opus 5.5 自由发挥时,动画往往是淡入、弹出、平移这几样;video-shotcraft 则准备了 124 张调校好的镜头配方卡、共 150 个镜头,分成开场与品牌、运镜与空间、转场、文字与字卡、界面登场、数据与指标、光效、收尾等 10 类。每张卡都有一份写给 agent 的说明和对应的 Remotion 实现,在它的 镜头库 里能直接看动效预览、复制卡名:
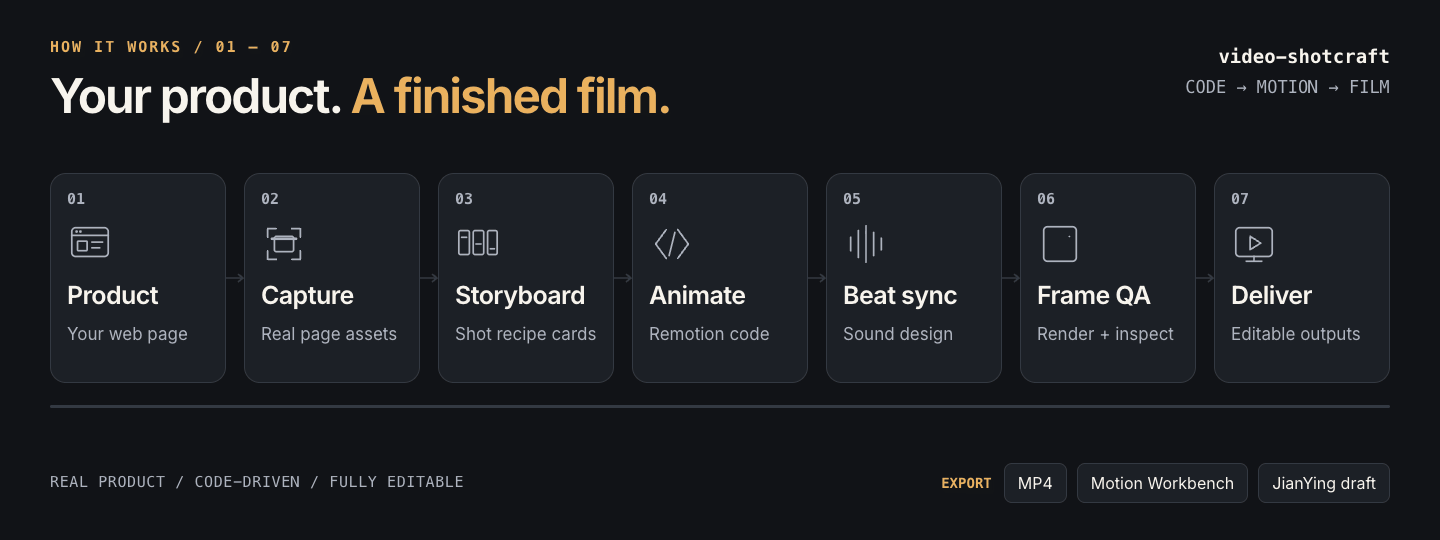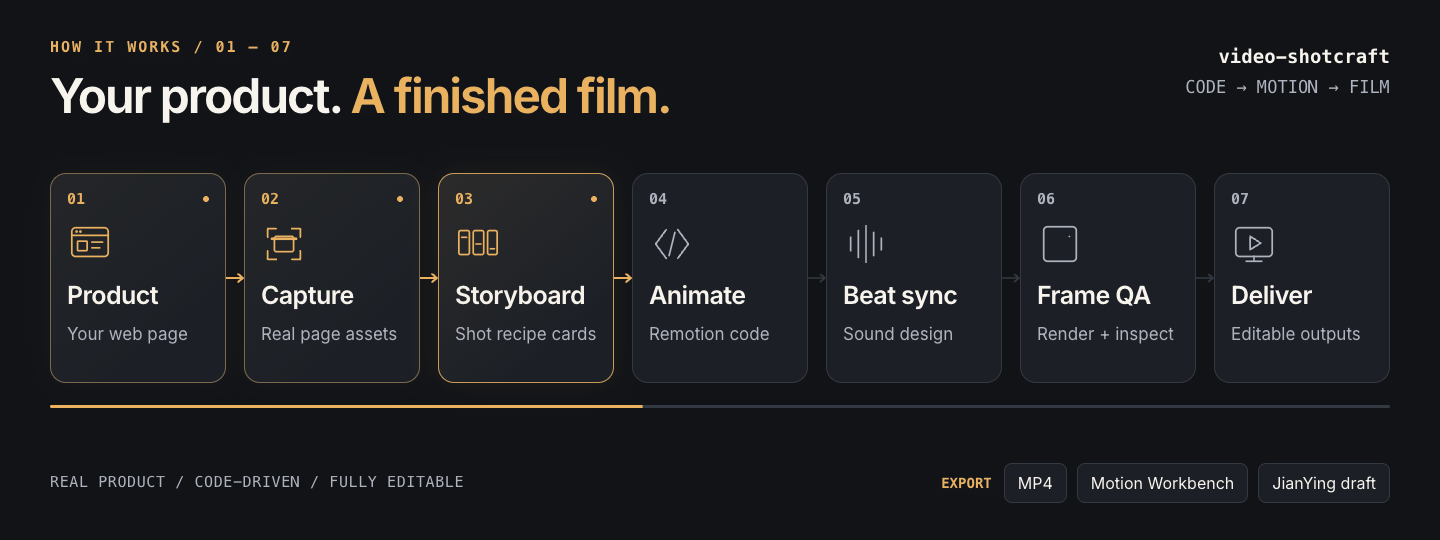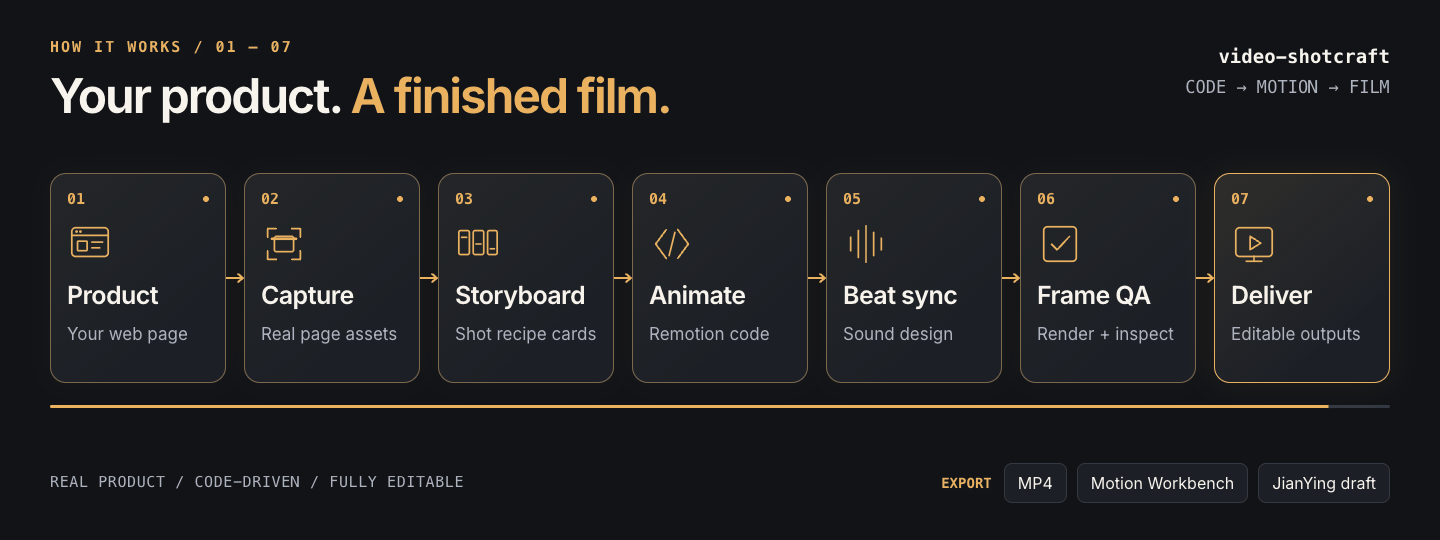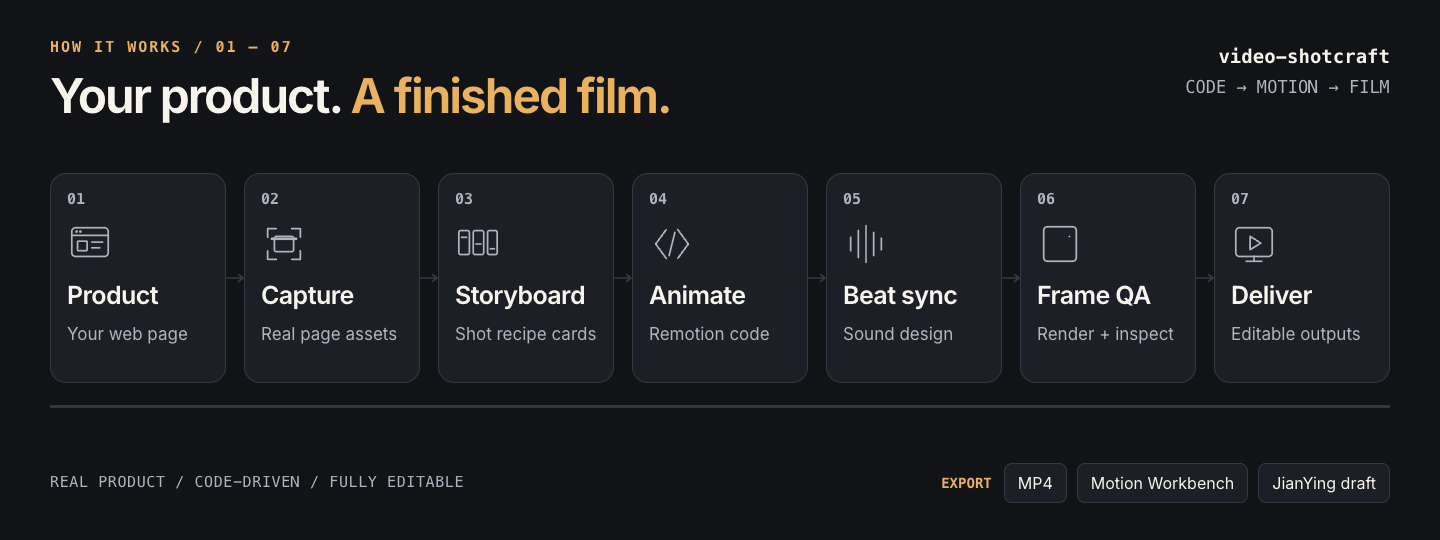
对它说一句「给我的产品做一支宣传片」,agent 会按这样的流程走:抓取你产品的真实页面 → 从配方库里挑镜头、排分镜 → 用 Remotion 做动画 → 按背景音乐的节拍卡点剪辑、配音效 → 渲染并逐帧检查 → 交付 MP4。
几个值得一看的点:
- 画面来自你的真实产品:它不是视频生成模型,每一帧都是代码基于你自己的截图和文案画出来的,品牌、文字都准确,也能逐项修改。
- 可以点名用哪个镜头:比如「参考 spotlight-hero-card,为这个页面设计一个产品特写镜头」,卡名直接从镜头库复制。
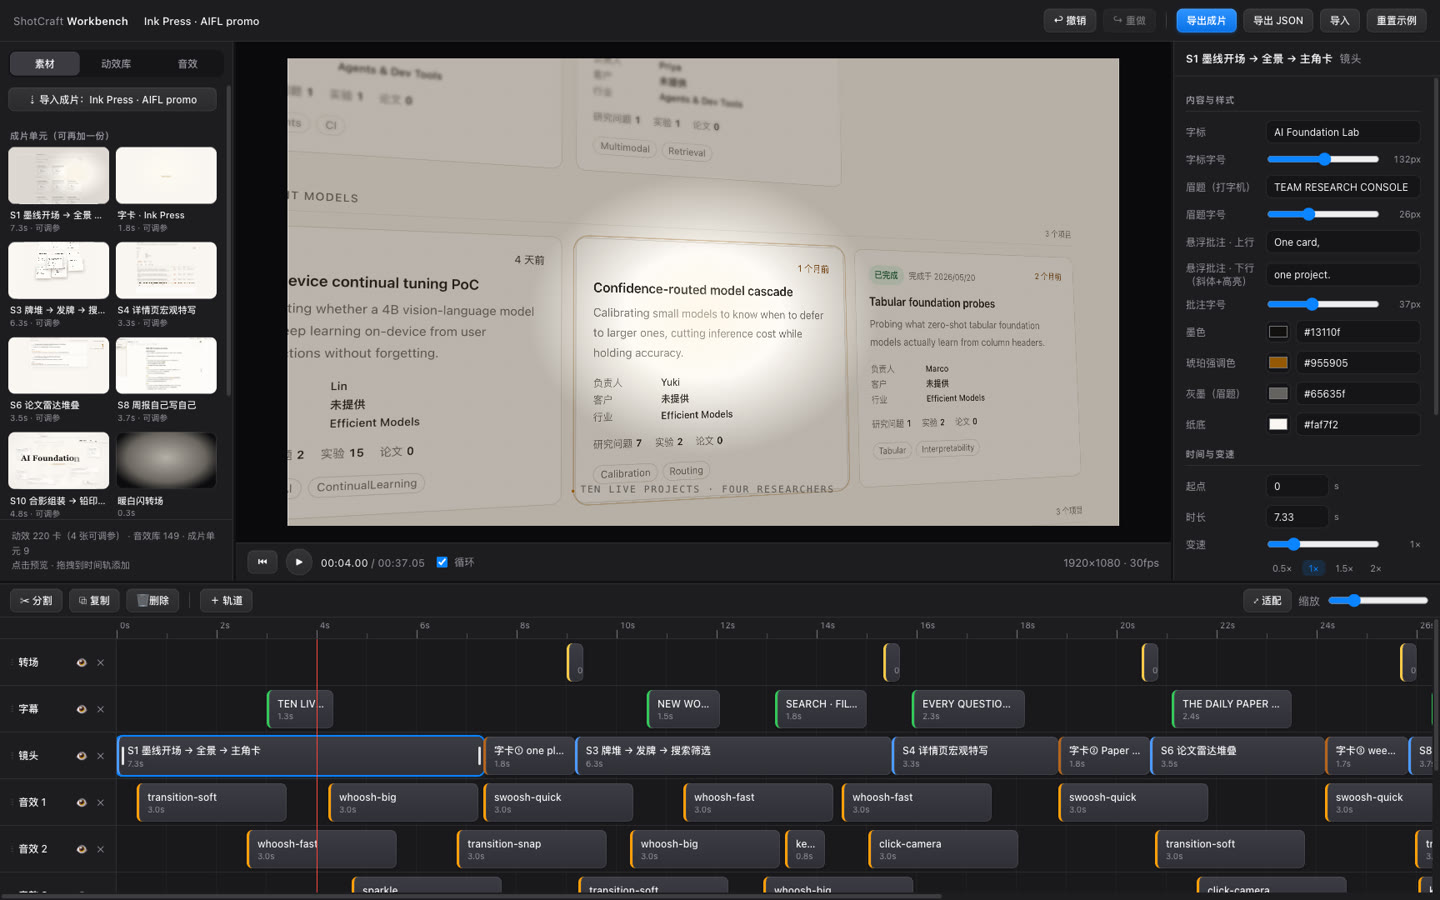
- 交付后还能像剪映一样改:它会在浏览器里打开一个「动效工作台」,成片按镜头拆成多条轨道,可以改文案、挪镜头、变速、换镜头,改完用 Remotion 导出;也能导出成剪映草稿。这和第 3 节讲的 Remotion Studio 是同一个思路,只是更进一步,可以直接动手编辑:
安装方式最简单:把仓库链接丢给 agent,说 帮我安装这个 skill:https://github.com/Vincentwei1021/video-shotcraft。在 Cursor 里用的话,也可以把仓库克隆下来,放到项目的 .agents/skills/ 目录。
本节截图和动图来自 video-shotcraft 的 README 和官网,项目以 Apache-2.0 协议开源。